Qu’est-ce que l’indexation sémantique latente ?
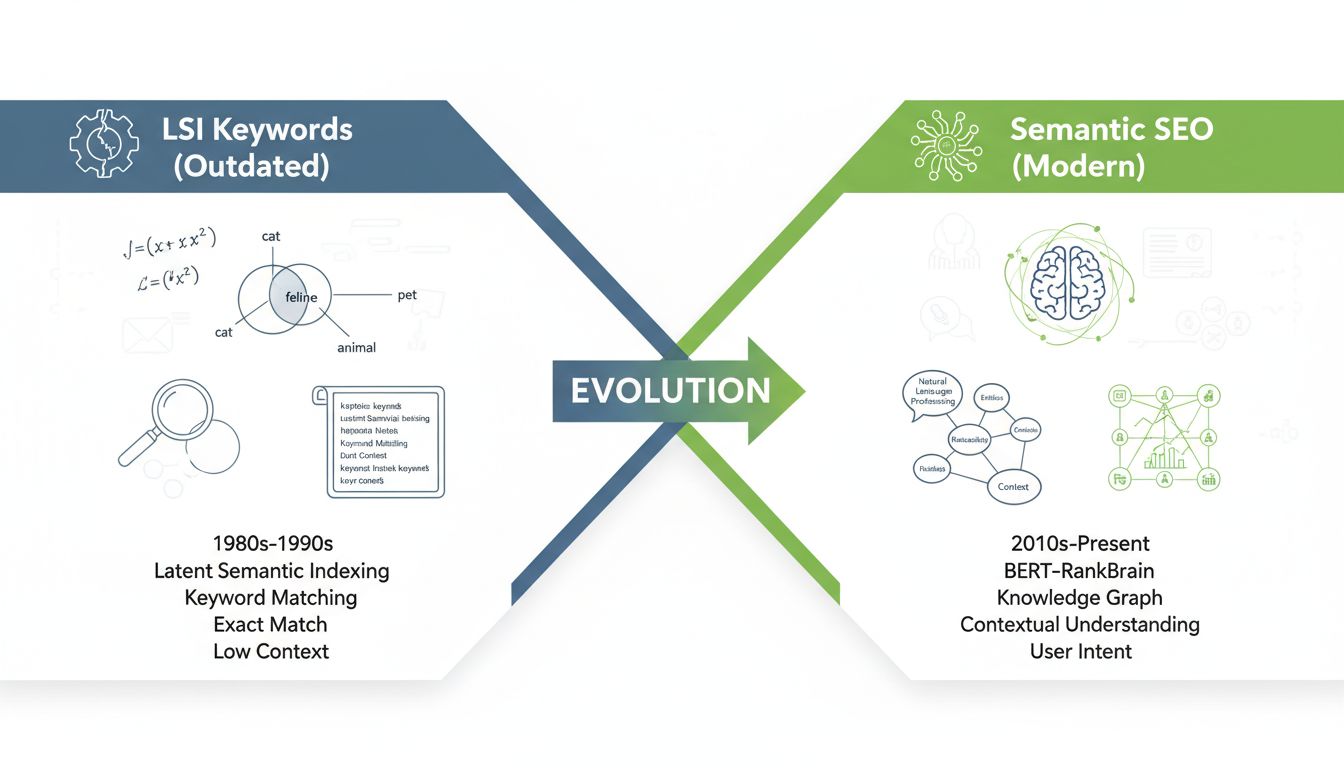
L’indexation sémantique latente (LSI) est une technique mathématique de traitement du langage naturel et de recherche d’information qui révèle les relations cachées — ou latentes — entre les mots et les documents. Au lieu de faire correspondre des mots-clés exacts, la LSI analyse les schémas de cooccurrence des mots dans un ensemble de documents pour déduire le sujet réel de chaque document.
Décomposer le nom rend le concept plus clair :
- Latente → cachée, non directement observable
- Sémantique → relative au sens dans le langage
- Indexation → organisation des informations pour la recherche
Lancez votre programme d'affiliation aujourd'hui
Configurez le suivi avancé en quelques minutes. Aucune carte de crédit requise.
La LSI fonctionne à travers une séquence d’étapes mathématiques bien définies. Les comprendre — même à un niveau élevé — clarifie pourquoi la technique est importante et où se situent ses limites.
Étape 1 : Construire la matrice termes-documents
La LSI commence par construire une matrice termes-documents. Chaque ligne représente un terme unique du corpus, chaque colonne représente un document, et chaque cellule enregistre le nombre de fois que ce terme apparaît dans ce document — ou, plus couramment, une valeur pondérée telle que TF-IDF (term frequency–inverse document frequency).
| Doc 1 | Doc 2 | Doc 3 |
|---|
| voiture | 3 | 0 | 1 |
| automobile | 0 | 4 | 1 |
| moteur | 2 | 3 | 0 |
| restaurant | 0 | 0 | 5 |
Cette matrice est généralement grande et creuse — la plupart des cellules sont nulles car un document donné n’utilise qu’une petite fraction du vocabulaire total.
Étape 2 : Appliquer la décomposition en valeurs singulières (SVD)
L’opération mathématique centrale de la LSI est la décomposition en valeurs singulières. La SVD décompose la matrice termes-documents en trois matrices plus petites :
Où
A est la matrice termes-documents originale,
Uₖ représente les termes dans un espace conceptuel réduit,
Σₖ contient les valeurs singulières qui pondèrent l’importance de chaque concept, et
Vₖᵀ représente les documents dans ce même espace réduit. L’indice
k est le nombre de dimensions que vous conservez — généralement bien inférieur à la taille du vocabulaire original.
Étape 3 : Réduction de dimensionnalité
En ne conservant que les k valeurs singulières les plus élevées (et en écartant les autres), la LSI réduit la matrice à une représentation beaucoup plus petite et plus dense. Cette étape supprime le bruit, fusionne les termes apparentés et fait émerger la structure sémantique latente. Le choix de k est crucial : trop petit et vous perdez des distinctions significatives ; trop grand et vous conservez du bruit. En pratique, k varie souvent de 100 à 300 pour des collections de taille modérée.
Étape 4 : Comparer les documents et les requêtes à l’aide de la similarité cosinus
Une fois les documents et les termes projetés dans l’espace sémantique réduit, les comparer devient simple. Une requête est projetée dans le même espace, et son vecteur est comparé à chaque vecteur de document à l’aide de la similarité cosinus — une mesure qui capture l’angle entre deux vecteurs, les valeurs proches de 1 indiquant une plus grande similarité.
Quelle est la différence entre LSI et LSA ?
Les termes indexation sémantique latente (LSI) et analyse sémantique latente (LSA) sont souvent utilisés de manière interchangeable, et pour cause : ils décrivent la même procédure mathématique sous-jacente. La distinction est une question d’application, pas de technique.
- LSA (analyse sémantique latente) fait référence à la méthode générale d’application de la SVD à une matrice termes-documents pour extraire la structure sémantique latente. Elle est utilisée dans la modélisation de sujets, la classification de textes et la recherche en sciences cognitives sur la mémoire humaine et l’acquisition du langage.
- LSI (indexation sémantique latente) fait spécifiquement référence à l’utilisation de cette même méthode pour la recherche d’information — indexer une collection de documents afin que les requêtes puissent être mises en correspondance avec les documents par le sens plutôt que par la simple superposition exacte de mots-clés.
En bref : la LSA est la technique d’analyse ; la LSI est son application à la recherche et à la récupération d’informations. L’article original de Deerwester et al. (1990) utilisait le terme « latent semantic indexing », c’est pourquoi la communauté de la recherche d’information a adopté LSI, tandis que les communautés plus larges du TALN et des sciences cognitives préfèrent généralement LSA.
Rejoignez notre newsletter
Soyez le premier à connaître les nouvelles fonctionnalités et mises à jour.
Où l’indexation sémantique latente est-elle utilisée ?
La LSI a été déployée dans divers systèmes concrets, en particulier avant l’essor des approches basées sur les réseaux de neurones.
La LSI a été l’une des premières techniques à permettre la recherche sémantique — récupérer des documents en fonction de la pertinence conceptuelle plutôt que de la superposition de mots-clés. Les premiers systèmes de recherche d’entreprise, les catalogues de bibliothèques numériques et les bases de données de recherche académique utilisaient la LSI pour améliorer le rappel : la proportion de documents pertinents effectivement récupérés.
Regroupement et catégorisation de documents
Parce que la LSI projette les documents dans un espace sémantique partagé, elle supporte naturellement le regroupement. Les documents sur des sujets similaires se retrouvent proches les uns des autres dans l’espace réduit, même s’ils ne partagent aucun vocabulaire exact. Cela a rendu la LSI utile pour la catégorisation automatique de sujets, l’examen de documents juridiques et la recherche de brevets.
Technologie éducative et notation automatique de dissertations
L’une des applications les plus citées de la LSA en dehors de la recherche est l’Intelligent Essay Assessor, développé à la fin des années 1990. Le système utilisait la LSA pour comparer les dissertations des étudiants à un corpus de textes rédigés par des experts, produisant des notes bien corrélées avec celles des correcteurs humains. Cette application a démontré que la LSA pouvait capturer des éléments significatifs du contenu textuel sans aucune règle linguistique ni connaissance spécifique au domaine.
Applications dans la recherche sur la mémoire humaine
Les recherches originales sur la LSA étaient en partie motivées par des questions de psychologie cognitive. Landauer et Dumais ont montré que la LSA pouvait reproduire certains aspects de l’acquisition du vocabulaire humain et des effets d’amorçage sémantique, suggérant que la seule structure statistique de l’exposition au langage pouvait expliquer une part importante de la façon dont les gens apprennent le sens des mots.
Est-ce que Google utilise la LSI comme facteur de classement ?
Non. Google n’utilise pas l’indexation sémantique latente dans ses algorithmes de classement. Ce n’est pas une spéculation — les représentants de Google l’ont déclaré directement.
La confusion a une origine historique. Au début des années 2000, à mesure que l’algorithme de Google devenait plus sophistiqué dans la compréhension du contexte, les praticiens du SEO ont cherché un cadre pour expliquer ce qu’ils observaient. La LSI — une technique réelle et publiée pour la compréhension sémantique — a fourni une étiquette pratique. L’idée que Google pourrait utiliser quelque chose comme la LSI pour « voir à travers » le bourrage de mots-clés et comprendre les sujets des pages était suffisamment plausible pour perdurer.
Mais l’approche moderne de Google pour comprendre le contenu est bien plus avancée. Des systèmes comme RankBrain (introduit en 2015), le neural matching et BERT (2019) utilisent l’apprentissage profond et des architectures basées sur les transformers pour modéliser le langage. Ces systèmes traitent l’ordre des mots, les fenêtres contextuelles, les relations entre entités et les signaux d’interaction utilisateur — rien de tout cela n’est géré par la LSI. La LSI est une technique d’algèbre linéaire opérant sur une représentation statique de sac de mots ; l’infrastructure de Google est des ordres de grandeur plus complexe.
Au milieu des années 2000, des outils SEO et des blogs ont commencé à promouvoir l’idée que Google utilisait la LSI pour identifier les termes apparentés et pénaliser les pages manquant de profondeur sémantique. Le concept était attrayant : il donnait aux spécialistes du SEO une justification à consonance scientifique pour rédiger un contenu plus riche et une tactique de type liste de contrôle (trouvez vos mots-clés LSI, saupoudrez-les, montez dans le classement). Des outils ont émergé, prétendant générer des mots-clés LSI pour n’importe quel sujet.
Le problème est que ce récit confond deux choses distinctes : la technique mathématique appelée LSI, et la pratique générale d’utiliser des termes apparentés dans le contenu.
Le conseil sous-jacent — rédiger un contenu complet et thématiquement riche — reste valable. L’étiquette est trompeuse.
Les « mots-clés LSI » existent-ils réellement ?
Au sens technique strict : non. Il n’existe aucun algorithme au sein de Google qui prend une requête, exécute une SVD sur une matrice termes-documents et renvoie une liste de « mots-clés LSI » que vous devriez inclure sur votre page.
Ce qui existe, c’est le phénomène observable selon lequel les pages bien classées pour une requête donnée ont tendance à utiliser un vocabulaire plus large de termes apparentés. Il s’agit d’une corrélation, pas d’une preuve d’un mécanisme basé sur la LSI. Les moteurs de recherche modernes utilisent des modèles de langage neuronaux entraînés sur de vastes corpus pour comprendre que « rendement énergétique », « MPG » et « moteur hybride » sont tous pertinents pour une page sur les voitures — sans jamais construire de matrice termes-documents ni calculer une seule valeur singulière.
Faut-il utiliser la LSI ou les embeddings pour un nouveau projet ?
Si vous construisez un système de recherche, un moteur de recommandation de contenu ou toute application ayant besoin de comprendre la similarité sémantique entre textes, la réponse est claire : utilisez les embeddings.
Quand la LSI peut encore avoir du sens
La LSI présente quelques avantages de niche. Elle est transparente — vous pouvez inspecter les vecteurs de termes et de documents et comprendre quelles dimensions contribuent à la similarité. Elle ne nécessite aucune donnée d’entraînement au-delà de la collection de documents elle-même. Elle fonctionne sur du matériel modeste et peut être implémentée en quelques dizaines de lignes de Python en utilisant TruncatedSVD de scikit-learn. Pour une petite collection statique de documents — par exemple, quelques milliers de descriptions de produits sur un site d’affiliation — la LSI peut fournir des résultats acceptables avec une complexité minimale.
Pourquoi les embeddings l’emportent pour presque tout le reste
Les modèles d’embedding modernes — qu’il s’agisse de sentence transformers comme all-MiniLM-L6-v2, d’API propriétaires d’OpenAI ou Cohere, ou de modèles open-weight — capturent des relations sémantiques bien plus riches que ce que la LSI a jamais pu offrir. Ils comprennent l’ordre des mots, la négation, les relations entre entités et la sémantique cross-lingue. Ils gèrent la polysémie de manière contextuelle : « banque » en tant qu’institution financière et « banque » en tant que rive d’un fleuve obtiennent des représentations vectorielles différentes selon les mots environnants.
| Critère | LSI | Embeddings modernes |
|---|
| Gère la synonymie | Oui, partiellement | Oui, efficacement |
| Gère la polysémie | Non (un vecteur par terme) | Oui (contextuel) |
| Capture l’ordre des mots | Non (sac de mots) | Oui |
| Données d’entraînement nécessaires | Aucune au-delà du corpus cible | Pré-entraîné sur de grands corpus |
| Coût computationnel | Faible | Modéré à élevé |
| Interprétabilité | Élevée (dimensions inspectables) | Faible (vecteurs boîte noire) |
| Meilleur pour | Collections petites et statiques | Recherche en production, RAG, recommandations |
Pour tout projet qui va croître, servir de vrais utilisateurs ou devoir comprendre des requêtes nuancées, les embeddings sont le bon choix.
Où la LSI est-elle encore utile ?
Bien que supplantée pour la recherche à grande échelle, la LSI reste pertinente dans plusieurs contextes spécifiques.
Éducation et apprentissage
La LSI est un excellent outil pédagogique. Son mécanisme — construire une matrice, la décomposer et mesurer la similarité dans l’espace réduit — rend concrète l’idée abstraite de « similarité sémantique ». Les étudiants qui implémentent la LSI à partir de zéro acquièrent une véritable compréhension des modèles vectoriels qui se transpose directement au travail avec les embeddings modernes.
Recherche et regroupement de documents à petite échelle
Pour une collection de quelques milliers de documents — wikis internes, catalogues de produits, contrats juridiques — la LSI peut être déployée rapidement sans GPU, sans frais d’API et sans infrastructure de service de modèles. Les résultats ne sont pas à la pointe de la technologie, mais ils sont souvent suffisants pour des outils internes et des prototypes.
Référence pour l’évaluation de nouvelles méthodes
Les chercheurs et les ingénieurs utilisent encore la LSI comme référence lors de l’évaluation de nouvelles techniques de recherche ou de modélisation de sujets. Si votre nouveau modèle neuronal sophistiqué surpasse à peine une méthode d’algèbre linéaire vieille de 30 ans, vous avez un problème. La LSI établit un seuil de référence utile.
Systèmes existants
Certains systèmes d’entreprise de recherche et de gestion de documents ont déployé la LSI il y a des années et n’ont aucune raison impérieuse de migrer. Si la collection est stable, les schémas de requêtes sont bien compris et les utilisateurs sont satisfaits, remplacer la LSI par des embeddings peut être une solution à la recherche d’un problème.
Pertinence pratique pour les spécialistes du marketing d’affiliation et les gestionnaires de programme
Si la LSI n’est pas un facteur de classement Google et que les « mots-clés LSI » n’existent pas, que doit réellement faire un spécialiste du marketing d’affiliation ou un gestionnaire de programme ? La réponse est plus simple — et plus efficace — que de chercher une liste magique de mots-clés.
Rédigez un contenu thématiquement complet
La véritable idée derrière le concept de mot-clé LSI est que les pages qui couvrent un sujet de manière approfondie ont tendance à mieux se classer. Cela ne nécessite pas de SVD. Cela nécessite de comprendre quelles questions votre public se pose et d’y répondre. Pour une page d’affiliation examinant des trackers d’activité, cela signifie couvrir l’autonomie de la batterie, les indices d’étanchéité, la précision du rythme cardiaque, la qualité de l’application compagnon et les comparaisons de prix — non pas parce qu’un algorithme exige ces termes, mais parce que les lecteurs les attendent.
Utilisez les outils pour ce qu’ils font réellement
Les outils de recherche de mots-clés sont précieux pour découvrir des requêtes connexes, comprendre le volume de recherche et analyser le contenu des concurrents. Utilisez-les pour cela. Ne les utilisez pas parce qu’ils prétendent générer des « mots-clés LSI ». L’autocomplétion de Google, les boîtes « Les gens demandent aussi » et les « Recherches associées » en bas de la SERP sont gratuits et reflètent directement les requêtes réelles des utilisateurs — ils sont plus utiles que n’importe quel outil LSI tiers.
Concentrez-vous sur les entités et les sujets, pas sur la fréquence des termes
L’approche moderne de Google pour comprendre le contenu tourne autour des entités — choses réelles, personnes, lieux et concepts — et de leurs relations. Lorsque vous écrivez sur un produit, mentionnez la marque, la catégorie, le cas d’usage, les alternatives et les spécifications pertinentes. Ce sont des entités. Les couvrir naturellement signale une profondeur thématique qu’un système d’apprentissage automatique peut reconnaître, sans aucun besoin d’une technique de décomposition de matrice obsolète.
Limitations de l’indexation sémantique latente
La LSI présente des limitations bien documentées qui expliquent pourquoi elle a été largement supplantée.
Hypothèse du sac de mots
La LSI traite chaque document comme une collection non ordonnée de mots. L’ordre des mots, la syntaxe et la structure grammaticale sont totalement ignorés. « Le chien a mordu l’homme » et « L’homme a mordu le chien » produisent des représentations identiques. Pour de nombreuses requêtes réelles, cela pose problème.
Un vecteur par terme
Dans la LSI, chaque terme reçoit exactement un vecteur — indépendamment du contexte. Le mot « batte » (animal vs équipement sportif) a la même représentation dans chaque document. Les embeddings contextuels modernes résolvent ce problème en produisant différents vecteurs pour le même mot dans différents contextes.
Exigence de corpus statique
La LSI construit son espace sémantique à partir d’une collection fixe de documents. L’ajout de nouveaux documents nécessite de recalculer la SVD — ou au minimum de projeter les nouveaux documents dans l’espace existant, ce qui peut ne pas bien capturer le nouveau vocabulaire. Cela rend la LSI inadaptée aux collections dynamiques comme les flux d’actualités ou les catalogues de produits constamment mis à jour.
Difficulté avec le passage à l’échelle
La SVD est coûteuse en calcul sur les grandes matrices. Une matrice termes-documents pour une collection à l’échelle du web serait intraitable. La technique a été conçue pour des collections de milliers à des dizaines de milliers de documents — des ordres de grandeur plus petites que ce que les moteurs de recherche modernes traitent.
Aucune gestion de la négation ou des nuances
La LSI ne peut pas distinguer « bon » de « pas bon » — les deux contiennent « bon » à proximité similaire d’autres termes. Le sentiment, le sarcasme et les distinctions de sens fines sont hors de sa portée.
LSI et contenu d’affiliation
L’expression « mots-clés LSI » est souvent utilisée de manière approximative dans les conseils SEO. Un mot apparenté n’est pas la preuve qu’un moteur de recherche utilise l’indexation sémantique latente. Pour un comparatif d’affiliation ou un guide produit, répondez aux véritables questions de l’acheteur et expliquez les concepts pertinents naturellement ; n’ajoutez pas une liste de prétendus termes LSI pour courir après le classement.