Qu’est-ce que la signification statistique ?
La définition fondamentale
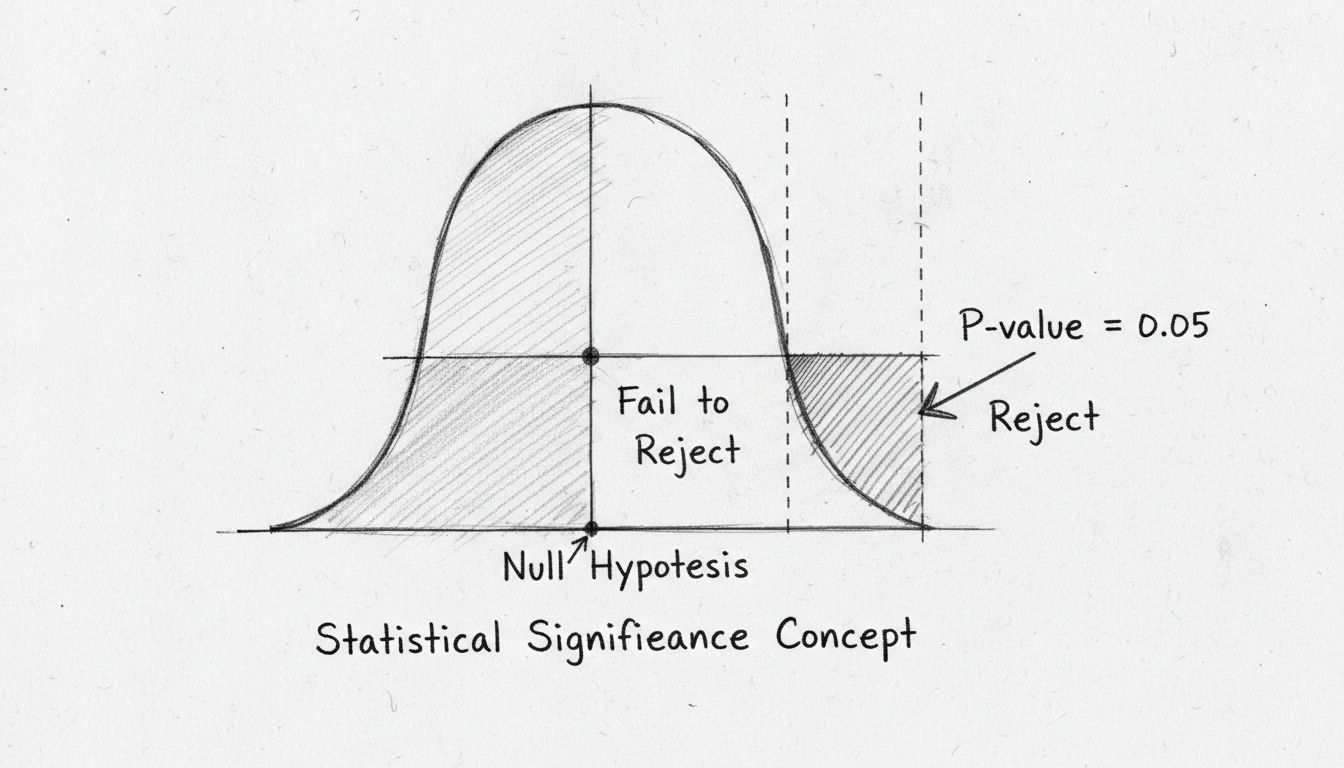
La signification statistique est la probabilité qu’une relation entre deux ou plusieurs variables soit causée par autre chose que le hasard. En termes formels, il s’agit de la probabilité qu’une différence observée — ou une différence plus extrême — se produise si l’hypothèse nulle (l’hypothèse d’absence d’effet réel) était vraie.
Signification statistique vs. hasard
Chaque ensemble de données contient une variation aléatoire — la fluctuation naturelle qui se produit même lorsqu’aucun effet sous-jacent n’existe. Lancez une pièce équitable 100 fois, et vous obtiendrez rarement exactement 50 faces. Cet écart est un bruit aléatoire, pas une preuve que la pièce est truquée.
La signification statistique quantifie si l’écart que vous observez est suffisamment grand, par rapport à la taille de votre échantillon, pour être improbable sous le seul effet du bruit aléatoire. Lorsque c’est le cas, vous pouvez rejeter l’hypothèse nulle et conclure qu’un effet réel existe probablement.
Deux concepts connexes aident ici :
- Le hasard : La probabilité qu’une différence observée provienne uniquement de la variabilité d’échantillonnage.
- La variation aléatoire (ou bruit aléatoire) : L’imprévisibilité inhérente à tout processus de mesure. Des échantillons plus grands réduisent son influence, rendant les effets réels plus faciles à détecter.
Un exemple concret simple
Supposons que vous gériez une boutique en ligne et testiez deux versions d’une page produit. La version A convertit à 4,2 %. La version B convertit à 4,8 %. C’est une différence de 0,6 point de pourcentage — mais est-elle réelle ?
Vous effectuez un test statistique. Il renvoie une valeur p de 0,03.
Si la valeur p était de 0,30, cependant, le même écart serait tout à fait compatible avec le hasard — et agir en conséquence serait prématuré.
Lancez votre programme d'affiliation aujourd'hui
Configurez le suivi avancé en quelques minutes. Aucune carte de crédit requise.
L’hypothèse nulle et l’hypothèse alternative
Tout test de signification commence par deux énoncés concurrents :
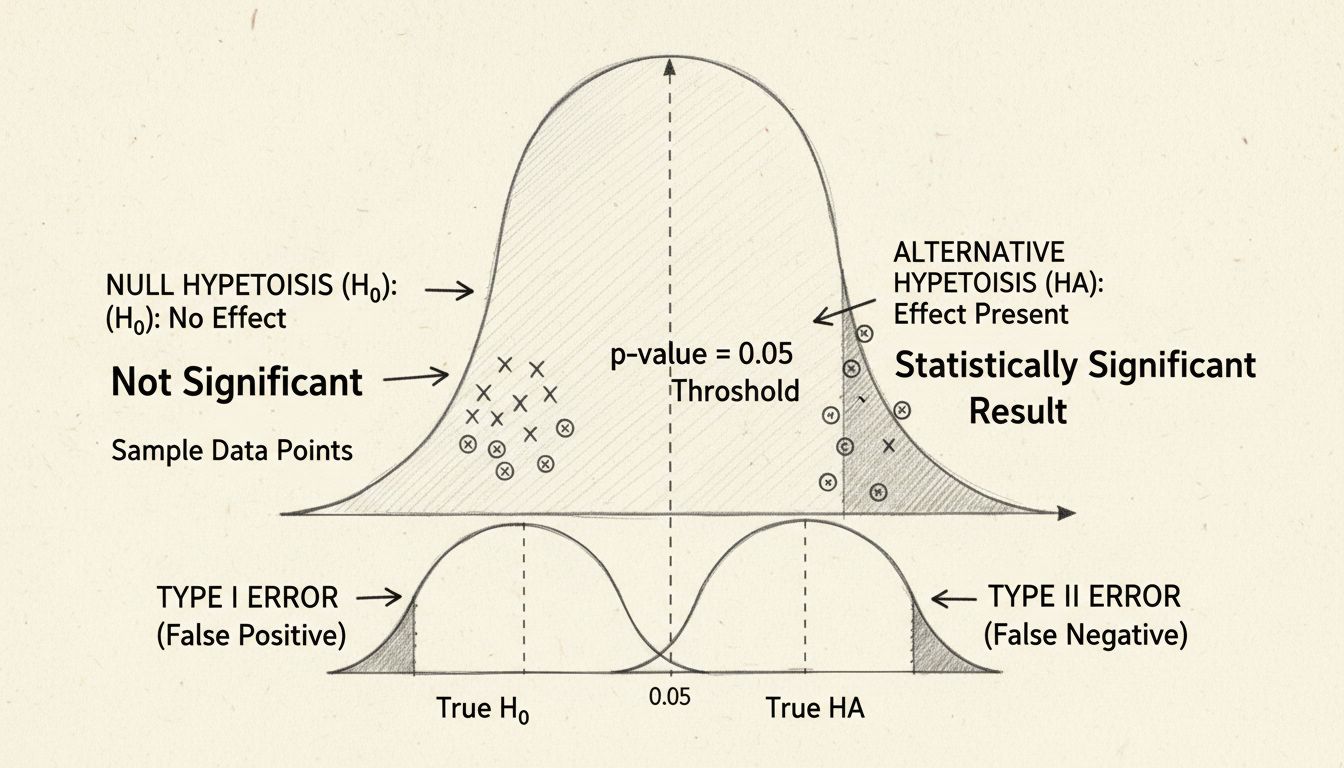
- Hypothèse nulle (H₀) : Il n’y a pas de différence ou de relation réelle. Toute différence observée est due à la variation aléatoire.
- Hypothèse alternative (H₁) : Il existe une différence ou une relation réelle.
Comprendre les valeurs p
Erreurs d’interprétation courantes à éviter :
- p = 0,03 ne signifie PAS qu’il y a 3 % de chances que l’hypothèse nulle soit vraie. Cela décrit la probabilité des données sous l’hypothèse nulle, pas la probabilité de l’hypothèse nulle compte tenu des données.
- p = 0,03 ne signifie PAS que l’effet a 97 % de chances d’être réel. La valeur p ne dit rien sur la probabilité que l’hypothèse alternative soit correcte.
- Une valeur p supérieure à 0,05 ne prouve PAS l’hypothèse nulle. Cela signifie que les données ne sont pas assez surprenantes pour la rejeter — ce qui est un énoncé complètement différent.
Niveaux de signification (Alpha)
Le niveau de signification, noté α (alpha), est le seuil que vous définissez avant d’exécuter un test. Il représente votre tolérance aux faux positifs — rejeter l’hypothèse nulle alors qu’elle est en réalité vraie. C’est ce qu’on appelle aussi une erreur de type I.
| Seuil | Signification | Risque de faux positif |
|---|
| α = 0,05 | Standard dans la plupart des domaines | 5 % (1 sur 20) |
| α = 0,01 | Plus strict ; utilisé lorsque les faux positifs sont coûteux | 1 % (1 sur 100) |
| α = 0,001 | Très strict ; décisions à enjeux élevés | 0,1 % (1 sur 1 000) |
Si p < α, le résultat est statistiquement significatif à ce niveau.
Intervalles de confiance expliqués
Un intervalle de confiance fournit une plage de valeurs plausibles pour l’ampleur réelle de l’effet. Un intervalle de confiance à 95 % signifie : si vous répétiez l’étude 100 fois, environ 95 de ces intervalles contiendraient la valeur réelle.
Des intervalles plus étroits indiquent des estimations plus précises — généralement le résultat de tailles d’échantillon plus grandes. Dans un contexte commercial, les intervalles de confiance sont souvent plus informatifs que les valeurs p seules car ils montrent l’ampleur et la direction d’un effet, et pas seulement son existence.
Est-ce que 0,05 est statistiquement significatif ? (et autres seuils)
La convention du 0,05
Oui — dans la plupart des domaines appliqués, p < 0,05 est la norme pour revendiquer une signification statistique. Cette convention remonte aux travaux de Ronald Fisher dans les années 1920, et bien qu’elle soit quelque peu arbitraire, elle a perduré car elle équilibre deux risques : les faux positifs (erreurs de type I) et les faux négatifs (erreurs de type II, où un effet réel est manqué).
0,01 vs. 0,05 : quel est le plus significatif ?
Une valeur p de 0,01 est plus significative sur le plan statistique que 0,05 car elle indique une probabilité plus faible que le résultat observé soit dû au hasard. À α = 0,01, vous n’acceptez qu’un risque de 1 % de faux positif, contre 5 % à α = 0,05.
Cependant, une valeur p plus faible ne signifie pas automatiquement un effet plus grand ou plus important. Avec un échantillon massif, même une différence insignifiante peut produire p < 0,001. C’est pourquoi la taille de l’effet et la signification pratique doivent être évaluées en parallèle de la valeur p.
Rejoignez notre newsletter
Soyez le premier à connaître les nouvelles fonctionnalités et mises à jour.
Facteurs qui affectent la signification statistique
Taille de l’échantillon
La taille de l’échantillon est le facteur le plus influent. Des échantillons plus grands réduisent l’impact de la variation aléatoire, rendant les vraies différences plus faciles à détecter. C’est pourquoi une augmentation de conversion de 2 % peut être significative avec 50 000 visiteurs mais pas avec 500.
Taille de l’effet
La taille de l’effet mesure l’ampleur de la différence observée — pas seulement son existence. Une grande taille d’effet (par exemple, une augmentation de conversion de 30 %) atteint la signification plus rapidement et avec des échantillons plus petits. Une petite taille d’effet (par exemple, 0,5 %) nécessite des échantillons énormes pour être détectée de manière fiable.
C’est là que la relation entre signification statistique et signification pratique devient cruciale. Un résultat peut être statistiquement significatif mais pratiquement irrelevant si l’effet est trop faible pour avoir de l’importance dans les décisions commerciales.
Qualité des données
Aucun test statistique ne peut compenser des données de mauvaise qualité. Les problèmes courants de qualité des données incluent :
- Biais de sélection : L’échantillon ne représente pas la population cible.
- Erreur de mesure : La métrique suivie est peu fiable ou incohérente.
- Variables confusionnelles : Un facteur non mesuré est à l’origine de la différence observée.
Avant de calculer la signification statistique, vérifiez que votre collecte de données est propre, cohérente et exempte de biais systématique. Un résultat significatif issu de données défectueuses est pire que l’absence de résultat.
Puissance statistique
La puissance statistique est la probabilité qu’un test détecte un effet réel lorsqu’il existe. Elle est complémentaire du taux d’erreur de type II (β).
La puissance dépend de la taille de l’échantillon, de la taille de l’effet et du niveau de signification choisi. Les études sous-dimensionnées sont une raison courante pour laquelle des résultats de tests A/B apparemment prometteurs ne se reproduisent pas.
La définition fondamentale
La signification statistique est la probabilité qu’une relation entre deux ou plusieurs variables soit causée par autre chose que le hasard. En termes formels, il s’agit de la probabilité qu’une différence observée — ou une différence plus extrême — se produise si l’hypothèse nulle (l’hypothèse d’absence d’effet réel) était vraie.
Ce cadre provient des tests d’hypothèse, une branche de l’analyse statistique développée au début du XXe siècle par Ronald Fisher et affinée par Jerzy Neyman et Egon Pearson.
Signification statistique vs. hasard
Chaque ensemble de données contient une variation aléatoire — la fluctuation naturelle qui se produit même lorsqu’aucun effet sous-jacent n’existe. Lancez une pièce équitable 100 fois, et vous obtiendrez rarement exactement 50 faces. Cet écart est un bruit aléatoire, pas une preuve que la pièce est truquée.
La signification statistique quantifie si l’écart que vous observez est suffisamment grand, par rapport à la taille de votre échantillon, pour être improbable sous le seul effet du bruit aléatoire. Lorsque c’est le cas, vous pouvez rejeter l’hypothèse nulle et conclure qu’un effet réel existe probablement.
Deux concepts connexes aident ici :
- Le hasard : La probabilité qu’une différence observée provienne uniquement de la variabilité d’échantillonnage.
- La variation aléatoire (ou bruit aléatoire) : L’imprévisibilité inhérente à tout processus de mesure. Des échantillons plus grands réduisent son influence, rendant les effets réels plus faciles à détecter.
Un exemple concret simple
Supposons que vous gériez une boutique en ligne et testiez deux versions d’une page produit. La version A convertit à 4,2 %. La version B convertit à 4,8 %. C’est une différence de 0,6 point de pourcentage — mais est-elle réelle ?
Vous effectuez un test statistique. Il renvoie une valeur p de 0,03.
Si la valeur p était de 0,30, cependant, le même écart serait tout à fait compatible avec le hasard — et agir en conséquence serait prématuré.
L’hypothèse nulle et l’hypothèse alternative
Tout test de signification commence par deux énoncés concurrents :
- Hypothèse nulle (H₀) : Il n’y a pas de différence ou de relation réelle. Toute différence observée est due à la variation aléatoire.
- Hypothèse alternative (H₁) : Il existe une différence ou une relation réelle.
Le test ne prouve pas H₁ directement.
Ce cadre s’applique directement aux tests A/B.
Comprendre les valeurs p
Erreurs d’interprétation courantes à éviter :
- p = 0,03 ne signifie PAS qu’il y a 3 % de chances que l’hypothèse nulle soit vraie. Cela décrit la probabilité des données sous l’hypothèse nulle, pas la probabilité de l’hypothèse nulle compte tenu des données.
- p = 0,03 ne signifie PAS que l’effet a 97 % de chances d’être réel. La valeur p ne dit rien sur la probabilité que l’hypothèse alternative soit correcte.
- Une valeur p supérieure à 0,05 ne prouve PAS l’hypothèse nulle. Cela signifie que les données ne sont pas assez surprenantes pour la rejeter — ce qui est un énoncé complètement différent.
Niveaux de signification (Alpha)
Le niveau de signification, noté α (alpha), est le seuil que vous définissez avant d’exécuter un test. Il représente votre tolérance aux faux positifs — rejeter l’hypothèse nulle alors qu’elle est en réalité vraie. C’est ce qu’on appelle aussi une erreur de type I.
| Seuil | Signification | Risque de faux positif |
|---|
| α = 0,05 | Standard dans la plupart des domaines | — |
| α = 0,01 | Plus strict ; utilisé lorsque les faux positifs sont coûteux | — |
| α = 0,001 | Très strict ; décisions à enjeux élevés | — |
Si p < α, le résultat est statistiquement significatif à ce niveau.
Intervalles de confiance expliqués
Un intervalle de confiance fournit une plage de valeurs plausibles pour l’ampleur réelle de l’effet. Un intervalle de confiance à 95 % signifie : si vous répétiez l’étude 100 fois, environ 95 de ces intervalles contiendraient la valeur réelle.
Des intervalles plus étroits indiquent des estimations plus précises — généralement le résultat de tailles d’échantillon plus grandes. Dans un contexte commercial, les intervalles de confiance sont souvent plus informatifs que les valeurs p seules car ils montrent l’ampleur et la direction d’un effet, et pas seulement son existence.
La convention du 0,05
Oui — dans la plupart des domaines appliqués, p < 0,05 est la norme pour revendiquer une signification statistique. Cette convention remonte aux travaux de Ronald Fisher dans les années 1920, et bien qu’elle soit quelque peu arbitraire, elle a perduré car elle équilibre deux risques : les faux positifs (erreurs de type I) et les faux négatifs (erreurs de type II, où un effet réel est manqué).
0,01 vs. 0,05 : quel est le plus significatif ?
Une valeur p de 0,01 est plus significative sur le plan statistique que 0,05 car elle indique une probabilité plus faible que le résultat observé soit dû au hasard. À α = 0,01, vous n’acceptez qu’un risque de 1 % de faux positif, contre 5 % à α = 0,05.
Cependant, une valeur p plus faible ne signifie pas automatiquement un effet plus grand ou plus important. Avec un échantillon massif, même une différence insignifiante peut produire p < 0,001. C’est pourquoi la taille de l’effet et la signification pratique doivent être évaluées en parallèle de la valeur p.
Quand p < 0,001
Une valeur p inférieure à 0,001 signifie que le résultat observé se produirait par hasard moins d’une fois sur 1 000 si l’hypothèse nulle était vraie. C’est une preuve solide contre l’hypothèse nulle — mais cela ne garantit toujours pas l’importance pratique.
Taille de l’échantillon
La taille de l’échantillon est le facteur le plus influent. Des échantillons plus grands réduisent l’impact de la variation aléatoire, rendant les vraies différences plus faciles à détecter. C’est pourquoi une augmentation de conversion de 2 % peut être significative avec 50 000 visiteurs mais pas avec 500.
Pour les sites à faible trafic, cela signifie que les tests doivent être exécutés plus longtemps ou cibler des changements à effet plus important.
Taille de l’effet
La taille de l’effet mesure l’ampleur de la différence observée — pas seulement son existence. Une grande taille d’effet (par exemple, une augmentation de conversion de 30 %) atteint la signification plus rapidement et avec des échantillons plus petits. Une petite taille d’effet (par exemple, 0,5 %) nécessite des échantillons énormes pour être détectée de manière fiable.
C’est là que la relation entre signification statistique et signification pratique devient cruciale. Un résultat peut être statistiquement significatif mais pratiquement irrelevant si l’effet est trop faible pour avoir de l’importance dans les décisions commerciales.
Qualité des données
Aucun test statistique ne peut compenser des données de mauvaise qualité. Les problèmes courants de qualité des données incluent :
- Biais de sélection : L’échantillon ne représente pas la population cible.
- Erreur de mesure : La métrique suivie est peu fiable ou incohérente.
- Variables confusionnelles : Un facteur non mesuré est à l’origine de la différence observée.
Avant de calculer la signification statistique, vérifiez que votre collecte de données est propre, cohérente et exempte de biais systématique. Un résultat significatif issu de données défectueuses est pire que l’absence de résultat.
Puissance statistique
La puissance statistique est la probabilité qu’un test détecte un effet réel lorsqu’il existe. Elle est complémentaire du taux d’erreur de type II (β).
La puissance dépend de la taille de l’échantillon, de la taille de l’effet et du niveau de signification choisi. Les études sous-dimensionnées sont une raison courante pour laquelle des résultats de tests A/B apparemment prometteurs ne se reproduisent pas.
Tests statistiques courants
Différents types de données nécessitent différents tests :
| Test | Cas d’utilisation | Exemple |
|---|
| Test T | Comparaison des moyennes de deux groupes | Taux de conversion : Version A vs. Version B |
| Test du khi-deux | Comparaison des fréquences catégorielles | Taux de clics sur plusieurs créations publicitaires |
| Test Z | Comparaison des proportions avec de grands échantillons | Proportions de conversion des pages de destination |
| ANOVA | Comparaison des moyennes de trois groupes ou plus | Performances de plusieurs partenaires affiliés |
Utilisation de calculateurs et d’outils en ligne
Vous n’avez pas besoin de calculer la signification statistique à la main. Les outils les plus utilisés incluent :
- Plateformes de tests A/B (Optimizely, VWO, Google Optimize) — calculs de signification intégrés
- Calculateurs autonomes (outils d’Evan Miller, AB Testguide) — gratuits, en ligne
- Logiciels statistiques (R, SciPy de Python, SPSS) — pour des analyses personnalisées
La plupart des outils rapportent à la fois la valeur p et l’intervalle de confiance. Vérifiez toujours les deux avant de prendre une décision.
Processus étape par étape pour les tests A/B
- Définissez votre métrique : Choisissez une seule métrique principale (taux de conversion, taux de clics, revenu par visiteur).
- Calculez la taille d’échantillon requise : Utilisez un calculateur de taille d’échantillon basé sur votre taux de conversion de référence et l’effet minimum détectable.
- Randomisez et exécutez le test : Répartissez le trafic équitablement entre le groupe de contrôle et le groupe de traitement. Ne vous arrêtez pas prématurément.
- Analysez les résultats : Comparez la valeur p à α. Examinez l’intervalle de confiance pour la taille de l’effet.
- Décidez : Si le résultat est significatif et a du sens en pratique, mettez en œuvre la variante gagnante. Sinon, documentez la conclusion et testez autre chose.
La signification statistique dans le marketing d’affiliation
La signification statistique n’est pas qu’un concept académique. Dans le marketing d’affiliation, où les commissions, les budgets et les relations avec les partenaires dépendent des données de performance, c’est une protection pratique contre des erreurs de jugement coûteuses.
Pour les annonceurs
Les annonceurs qui gèrent des programmes d’affiliation testent régulièrement les pages de destination, les structures d’offre et les supports créatifs. La signification statistique garantit que les décisions concernant la version à déployer sont basées sur de véritables différences de performance, et non sur des fluctuations aléatoires.
Exemple de processus : Un annonceur teste deux structures de commission — un taux fixe de 10 % contre un modèle progressif à 5 %/12 %/18 %. Après 30 jours et 5 000 transactions, le modèle progressif affiche une valeur moyenne de commande supérieure de 22 %. Un test T renvoie p = 0,02. L’annonceur peut déployer en toute confiance la structure progressive, sachant que la différence observée est peu probable d’être due au bruit aléatoire.
Sans test de signification, l’annonceur aurait pu effectuer le changement sur la base d’une fluctuation à court terme — et potentiellement réduire les revenus des partenaires si l’effet s’était inversé.
Pour les éditeurs
Les éditeurs (affiliés) prennent des décisions sur les produits à promouvoir, les sources de trafic dans lesquelles investir et les formats de contenu qui convertissent le mieux. Chacune de ces décisions bénéficie d’un test de signification.
Exemple de processus : Un éditeur teste deux versions d’un article d’avis — l’une avec un tableau comparatif en haut, l’autre avec ce tableau en bas. Sur 10 000 pages vues, la version avec le tableau en haut génère un taux de clics de 3,1 % vers le marchand contre 2,6 % pour la version avec le tableau en bas. Un test du khi-deux donne p = 0,04. L’éditeur adopte le format avec le tableau en haut et applique ce modèle à d’autres avis.
Pour les gestionnaires de programmes d’affiliation
Les gestionnaires de programmes évaluent les performances des partenaires, définissent les paliers de commission et décident quels affiliés recruter ou conserver. La signification statistique aide à distinguer les performeurs constamment élevés de ceux dont les bons mois ne sont que de la variance.
Exemple de processus : Un gestionnaire de programme compare deux affiliés ayant des volumes de trafic similaires. L’affilié A a un taux de conversion de 5,2 % sur 12 mois ; l’affilié B a 4,1 %. Un test Z à deux échantillons confirme que la différence est significative (p = 0,008). Le gestionnaire utilise ces données pour attribuer des commissions de palier supérieur à l’affilié A et examine ce que l’affilié B pourrait améliorer.
Dans ces trois rôles, le principe est le même : laissez les données atteindre la signification avant d’agir. Les décisions prématurées — augmenter les commissions d’un partenaire qui a eu un bon mois, ou abandonner une page de destination qui a eu une mauvaise semaine — comptent parmi les erreurs les plus courantes et les plus évitables dans le marketing d’affiliation.
Limites et idées reçues courantes
Significatif ≠ important
C’est le malentendu le plus persistant. Un résultat peut être statistiquement significatif à p < 0,001 et être pourtant trop faible pour avoir de l’importance. Dans un exemple bien connu tiré du manuel de statistiques industrielles du NIST, une amélioration de processus de fabrication était statistiquement significative mais ne produisait qu’un gain de seulement 0,2 unité — bien en dessous du seuil de valeur pratique.
Posez toujours deux questions :
- Est-ce statistiquement significatif ? (la valeur p)
- L’effet est-il suffisamment grand pour qu’on s’y intéresse ? (la taille de l’effet)
P-hacking et la crise de la reproductibilité
Le P-hacking désigne la pratique consistant à effectuer de multiples analyses et à ne rapporter sélectivement que celles qui atteignent la signification. Les formes courantes incluent :
- Tester de nombreuses métriques et mettre en évidence celle qui « gagne »
- Arrêter la collecte de données lorsque p franchit le seuil de 0,05
- Exclure des valeurs aberrantes a posteriori pour faire baisser la valeur p
Ces pratiques augmentent considérablement les taux de faux positifs.
La leçon pour les utilisateurs professionnels : préenregistrez votre plan de test, tenez-vous-en à une seule métrique principale et résistez à la tentation de pêcher la signification.
Quand ne pas se fier à la signification statistique
La signification statistique est moins utile — ou carrément trompeuse — dans les scénarios suivants :
- Très petits échantillons : Avec moins de 100 observations par groupe, seuls des effets énormes atteindront la signification. Les résultats négatifs ne sont pas informatifs, ils ne sont pas une preuve d’absence d’effet.
- Changements simultanés multiples : Si vous modifiez cinq éléments d’une page à la fois, un résultat significatif ne peut pas vous dire quel changement a produit l’effet.
- Travail exploratoire à faible enjeu : Toutes les décisions ne nécessitent pas un test de signification formel. Pour l’exploration préliminaire, des données directionnelles peuvent suffire.