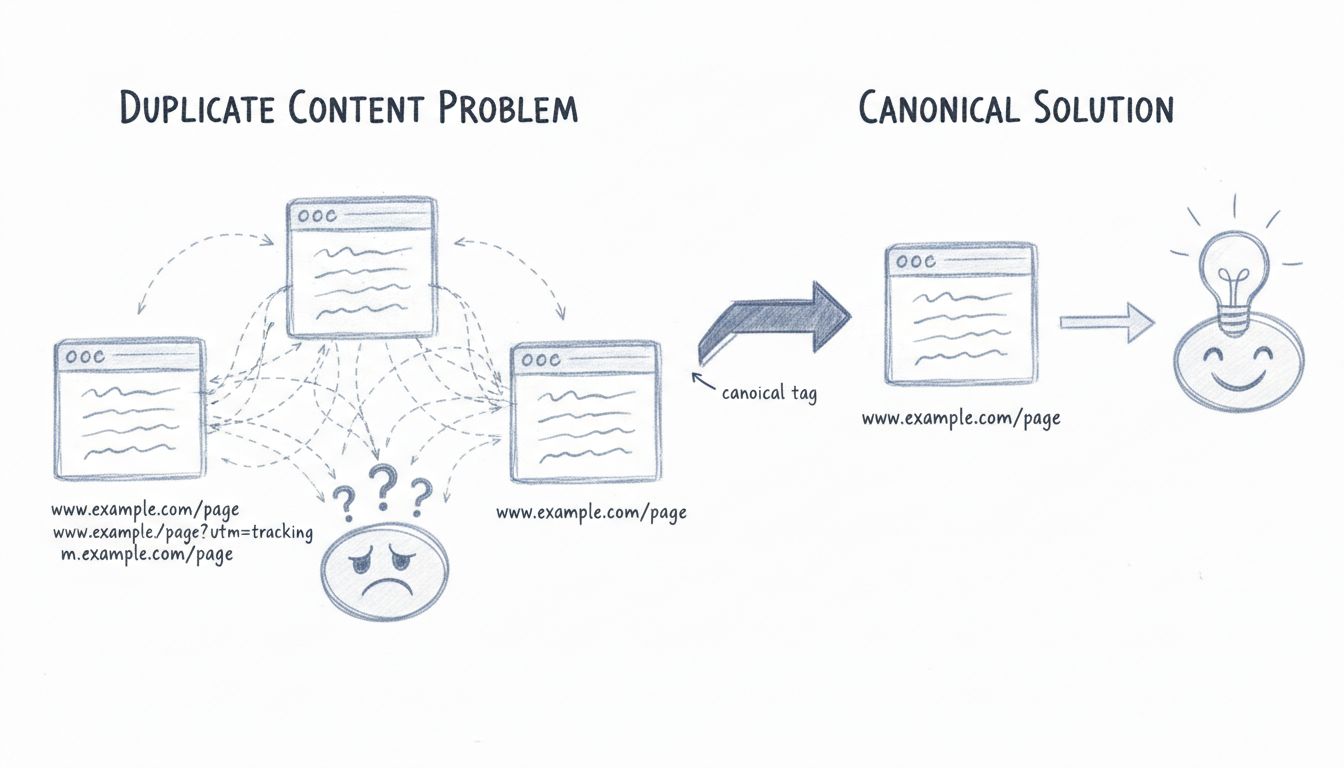
Le contenu dupliqué désigne des blocs substantiels de texte, de code ou de médias qui apparaissent à plusieurs endroits sur Internet — ce qui signifie que deux URL distinctes ou plus fournissent un contenu identique ou sensiblement similaire aux utilisateurs et aux moteurs de recherche. Lorsque Google, Bing ou tout autre robot d’exploration rencontre le même contenu à plusieurs adresses web, il doit décider quelle version indexer, laquelle classer et laquelle ignorer. Cette décision n’est pas toujours celle que vous auriez prise vous-même.
Comprendre le contenu dupliqué est essentiel pour quiconque gère un site web, un programme d’affiliation ou publie du contenu en ligne. Si rien n’est fait, il divise les signaux de classement, gaspille le budget d’exploration et perturbe les moteurs de recherche dont vous dépendez pour votre trafic.
Qu’est-ce que le contenu dupliqué ?
Le contenu dupliqué désigne un contenu identique ou sensiblement similaire qui existe à plusieurs URL. Ces URL peuvent appartenir au même domaine (duplication interne) ou à des sites web complètement différents (duplication externe).
Une page est considérée comme dupliquée lorsqu’elle présente un chevauchement notable dans le libellé, la structure et le message essentiel avec une autre page, n’ajoute que peu ou pas d’informations originales et n’offre aucune valeur significative au-delà de ce que l’autre version fournit déjà. Les en-têtes, pieds de page et éléments de navigation qui se répètent sur un site ne comptent pas — les moteurs de recherche comprennent qu’ils font partie d’un modèle et non du contenu substantiel lui-même.
Contenu dupliqué interne
La duplication interne se produit au sein d’un même domaine. Les scénarios courants incluent :
- Une page produit accessible à la fois sur
example.com/product et example.com/product?color=blue - Les versions HTTP et HTTPS d’une même page qui renvoient toutes deux un code de statut 200
- Les variantes WWW et non-WWW toutes deux accessibles et indexées
- Les versions imprimables d’articles générant des URL séparées
- Les filtres de catégorie et paramètres de tri créant des combinaisons d’URL infinies sur les sites e-commerce
Chacun de ces cas crée une adresse distincte pour le même contenu sous-jacent. Les moteurs de recherche voient plusieurs URL en compétition pour la même requête, et ils récompensent rarement toutes ces URL.
Contenu dupliqué externe
La duplication externe se produit lorsque le contenu d’un domaine apparaît sur un autre. Cela peut être malveillant — contenu récupéré et republié sans autorisation — ou tout à fait légitime, comme dans le cas d’articles syndiqués distribués à des sites partenaires. Sans balise canonique pointant vers l’original, les moteurs de recherche peuvent classer la copie au-dessus de la source, ou diviser les signaux de classement entre les deux.
Contenu identique ou quasi identique
Tout le contenu dupliqué n’est pas identique. Le contenu quasi dupliqué partage la même structure et le même message essentiel mais varie dans les petits détails : une page produit où seul le nom de la couleur change, une page de zone de service où seule la ville diffère, ou une version traduite du même article. Google traite ces pages comme des doublons lorsque les différences sont trop minces pour justifier une page séparée. Le seuil n’est pas un pourcentage fixe — il s’agit de savoir si chaque page apporte une valeur réellement distincte à l’internaute.
Lancez votre programme d'affiliation aujourd'hui
Configurez le suivi avancé en quelques minutes. Aucune carte de crédit requise.
Pourquoi le contenu dupliqué est-il important ?
Le contenu dupliqué crée trois problèmes concrets pour les moteurs de recherche comme pour les propriétaires de sites.
Confusion sur la version à indexer
Lorsque plusieurs URL diffusent le même contenu, les moteurs de recherche doivent en choisir une à stocker dans leur index. Ils peuvent choisir la mauvaise — une URL non optimisée chargée de paramètres au lieu de la version canonique propre. Les autres versions peuvent être entièrement supprimées, ce qui signifie que la page que vous souhaitez classer n’apparaît jamais dans les résultats de recherche.
Dilution de la valeur des liens
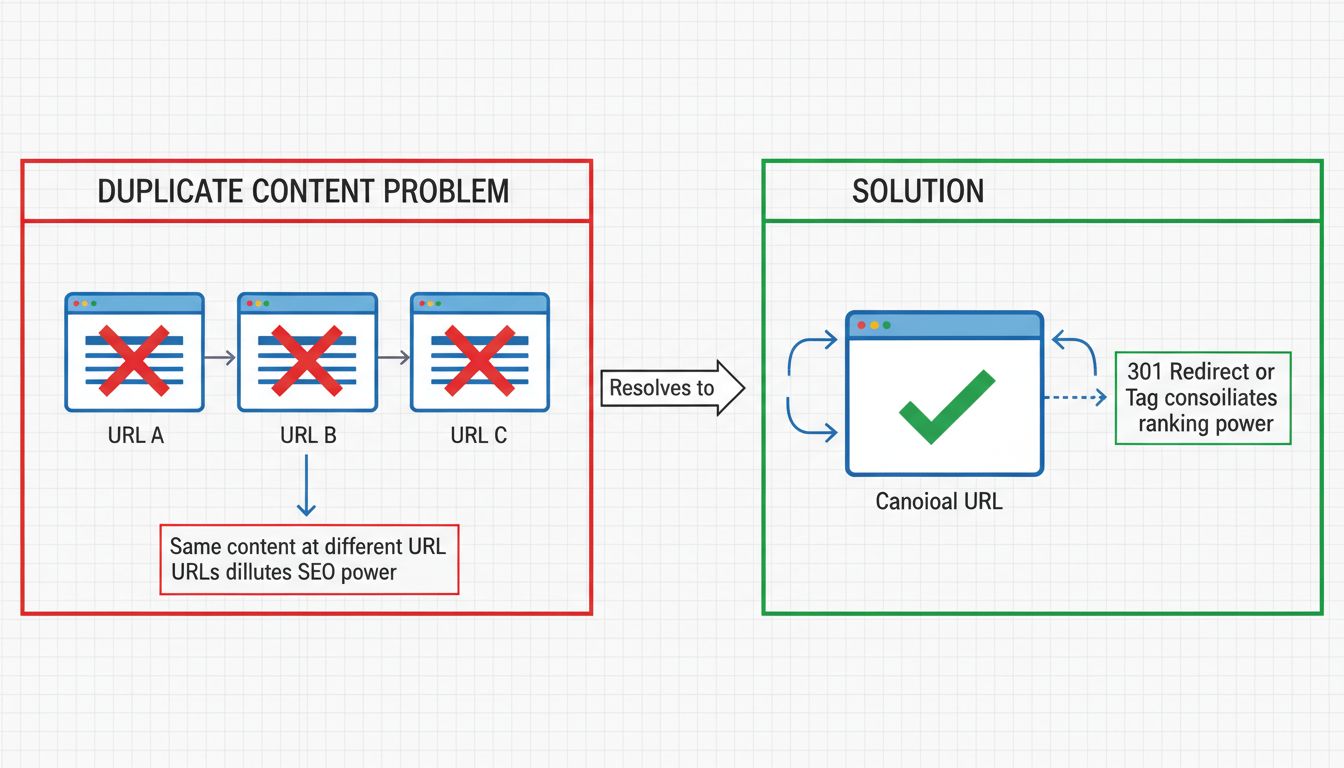
Les backlinks sont parmi les signaux de classement les plus puissants. Lorsque des sites externes créent des liens vers différentes versions du même contenu — certains vers la version HTTP, d’autres vers HTTPS, certains avec une barre oblique finale et d’autres sans — l’autorité que ces liens transportent est répartie entre plusieurs URL au lieu d’être concentrée sur une seule. Une page qui aurait pu être classée en troisième position pourrait se retrouver à la douzième parce que sa valeur de lien est fragmentée sur quatre URL dupliquées.
Gaspillage du budget d’exploration
Les moteurs de recherche allouent un temps et des ressources limités à l’exploration d’un site donné. Chaque URL dupliquée qu’un robot traite est une page unique et précieuse de moins qu’il peut découvrir et indexer dans cette session. Sur les grands sites — boutiques e-commerce avec des milliers d’UGS, hubs de contenu d’affiliation avec des pages générées dynamiquement — le gaspillage du budget d’exploration dû aux doublons peut supprimer la visibilité de pages pourtant importantes.
Est-ce que Google punit le contenu dupliqué ?
Non — pas dans le sens d’une pénalité manuelle. La plupart des contenus dupliqués sur le web sont accidentels, non trompeurs, et les systèmes de Google en tiennent compte.
La distinction est importante. Google agit bel et bien contre la duplication délibérément manipulatrice : les sites qui récupèrent et republient du contenu à grande échelle uniquement pour attirer du trafic de recherche, ou qui génèrent des milliers de pages passerelles quasi identiques bourrées de mots-clés. Dans ces cas, Google peut appliquer une action manuelle ou une suppression algorithmique. Mais pour le propriétaire de site ordinaire ayant quelques URL dupliquées générées par paramètres, la conséquence n’est pas une pénalité — c’est l’opportunité perdue de signaux divisés et de classements dilués.
Le résultat pratique est similaire : votre contenu sous-performe. Mais comprendre qu’il s’agit d’un effet de filtrage algorithmique plutôt que d’une frappe punitive vous aide à prioriser correctement les corrections. Vous ne cherchez pas à échapper à une pénalité ; vous consolidez une force qui vous appartient déjà.
Rejoignez notre newsletter
Soyez le premier à connaître les nouvelles fonctionnalités et mises à jour.
Causes courantes du contenu dupliqué
La plupart des contenus dupliqués sont créés accidentellement, par la façon dont les systèmes de gestion de contenu, les plateformes e-commerce et les architectures de site fonctionnent par défaut.
Paramètres d’URL et identifiants de session
Les paramètres de suivi (?utm_source=, ?session_id=), les options de tri (?sort=price) et les combinaisons de filtres génèrent des URL uniques pour ce qui est essentiellement la même page. Une seule page produit sur un site e-commerce peut générer des dizaines d’URL paramétrées, chacune indexée séparément si elle n’est pas gérée.
HTTP vs HTTPS et WWW vs non-WWW
Si votre site est accessible à la fois sur http://example.com et https://example.com, ou sur https://www.example.com et https://example.com, vous avez au moins deux versions de chaque page. Sans redirection à l’échelle du site de l’une vers l’autre, les deux versions peuvent être explorées et indexées.
Variations de barre oblique finale
example.com/page et example.com/page/ peuvent diffuser le même contenu mais sont enregistrés comme des URL différentes. La plupart des CMS modernes gèrent cela automatiquement, mais des serveurs mal configurés peuvent exposer les deux.
Pages adaptées à l’impression et pages AMP
Des URL séparées pour les versions optimisées pour l’impression ou les versions AMP des articles créent des doublons du contenu principal. Si ces versions alternatives sont indexables, elles entrent en concurrence avec l’original.
Contenu récupéré et syndiqué
Lorsque d’autres sites copient votre contenu — avec ou sans permission — ils créent des doublons externes. Même les partenaires de syndication légitimes ont besoin de balises canoniques pointant vers votre original ; sinon, leur version republiée peut surpasser la vôtre dans le classement.
Descriptions de produits dans le e-commerce et le marketing d’affiliation
Les fabricants fournissent souvent la même description de produit à des centaines de détaillants et d’affiliés. Lorsque chaque vendeur publie ce texte identique, les moteurs de recherche voient une duplication massive entre domaines.
Navigation à facettes et pages de catégorie filtrées
Les sites e-commerce et d’annonces qui permettent aux utilisateurs de filtrer par taille, couleur, gamme de prix ou note créent des explosions combinatoires d’URL. Une page de catégorie avec cinq options de filtre, chacune avec cinq valeurs, peut générer plus de 3 000 URL uniques — toutes affichant sensiblement la même grille de produits.
Environnements de staging et de développement
Les sites de staging accidentellement laissés indexables dupliquent l’intégralité du site de production. Une mauvaise configuration de robots.txt ou une balise noindex manquante sur un serveur de développement peut entraîner le miroir de l’ensemble du site dans les résultats de recherche.
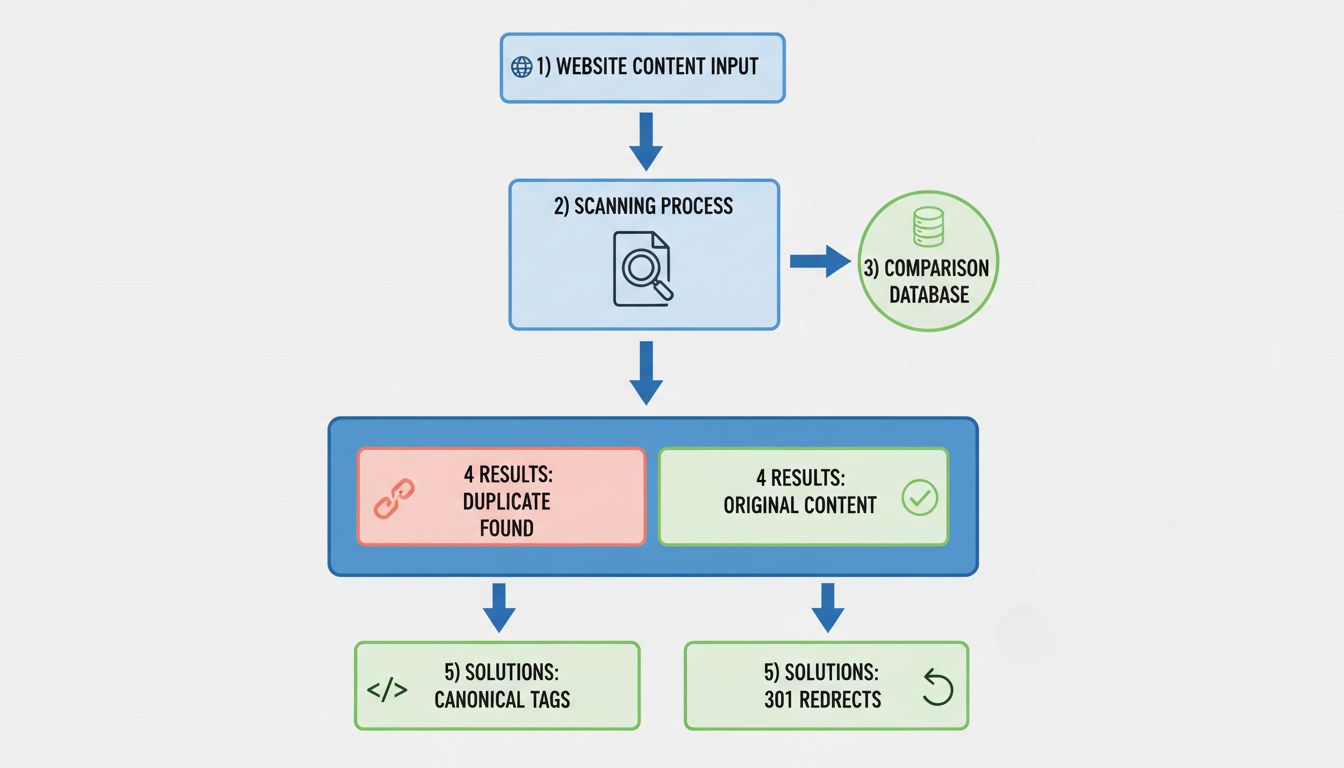
Avant de pouvoir corriger le contenu dupliqué, vous devez savoir où il se trouve. Plusieurs méthodes et outils rendent cette tâche simple.
Google Search Console
C’est le moyen le plus rapide et le plus fiable pour repérer les duplications qui affectent déjà votre classement.
Outils d’audit de site
Les robots d’exploration SEO dédiés — Screaming Frog, Sitebulb, Ahrefs Site Audit, Semrush Site Audit — explorent l’ensemble de votre site et signalent les pages avec des titres dupliqués, des méta-descriptions dupliquées et un contenu corporel quasi identique. Le rapport « Pages dupliquées » de Screaming Frog, par exemple, regroupe les URL par empreinte de contenu et montre exactement quelles pages partagent un contenu identique ou quasi identique. La plupart de ces outils offrent des niveaux gratuits suffisants pour les sites petits à moyens.
Recherches de correspondance exacte
Copiez une phrase distinctive de votre contenu — entre guillemets — et collez-la dans Google. Les résultats montrent chaque page indexée contenant cette phrase exacte. Si vous voyez des URL que vous n’attendiez pas, vous avez trouvé des doublons externes ou des pages internes que vous ne saviez pas indexées.
Vérificateurs de plagiat
Des outils comme Copyscape et Siteliner comparent votre contenu au web dans son ensemble et à d’autres pages de votre propre domaine. Copyscape est particulièrement utile pour trouver des sites qui ont récupéré votre contenu sans autorisation. Siteliner analyse les pourcentages de duplication interne sur votre domaine.
Vérifications manuelles des motifs courants
Vérifiez si votre site est accessible via plusieurs variantes de protocole et de sous-domaine. Ouvrez http://votresite.com, https://votresite.com, http://www.votresite.com et https://www.votresite.com. Si plusieurs d’entre eux aboutissent à une page active au lieu de rediriger, vous avez un problème systémique de contenu dupliqué qui affecte chaque page.
Corriger le contenu dupliqué consiste à indiquer aux moteurs de recherche quelle version d’une page vous souhaitez classer et à consolider tous les signaux derrière celle-ci.
Redirections 301
Une redirection 301 envoie définitivement les utilisateurs et les moteurs de recherche d’une URL dupliquée vers la version canonique. C’est le signal le plus fort que vous puissiez envoyer : il consolide la valeur des liens, supprime le doublon de l’index au fil du temps et garantit que les visiteurs atterrissent toujours sur la bonne page.
Utilisez les redirections 301 lorsque :
- Vous avez définitivement déplacé ou consolidé des pages
- Vous devez résoudre la duplication HTTP/HTTPS ou WWW/non-WWW à l’échelle du site
- Un produit ou un article a été remplacé par une version plus récente
- Vous fusionnez plusieurs pages légères en une seule ressource complète
Balises canoniques (rel=“canonical”)
<link rel="canonical" href="https://example.com/page-originale/" />
Les balises canoniques sont l’outil approprié lorsque :
- Vous devez garder les pages dupliquées accessibles aux utilisateurs (par exemple, vues de catégorie filtrées, URL paramétrées)
- Vous syndiquez du contenu vers des sites partenaires et souhaitez que le crédit revienne à l’original
- Plusieurs URL servent le même contenu pour des raisons légitimes d’expérience utilisateur
Contrairement à une redirection, une balise canonique ne supprime pas l’existence de l’URL dupliquée — elle indique seulement une préférence. Les moteurs de recherche la traitent comme un indice fort, non comme une directive absolue.
Balises méta Noindex
Une balise noindex demande aux moteurs de recherche de ne pas inclure une page dans leur index. Utilisez-la sur les pages qui servent un objectif pour les utilisateurs mais ne devraient jamais apparaître dans les résultats de recherche : pages de remerciement, pages de résultats de recherche internes, versions imprimables et environnements de staging.
<meta name="robots" content="noindex" />
Combinez noindex avec follow si vous souhaitez que la valeur des liens continue de circuler à travers la page vers d’autres destinations.
Maillage interne cohérent
Chaque fois que vous créez un lien vers une page de votre propre site, utilisez exactement le même format d’URL. Si votre version canonique est https://example.com/page/, ne créez pas de lien vers https://www.example.com/page ou http://example.com/page/ dans votre navigation, votre contenu corporel ou votre pied de page. L’incohérence dans vos propres liens envoie des signaux contradictoires qui sapent vos choix canoniques.
Gestion des paramètres d’URL dans Google Search Console
L’outil Paramètres d’URL de Google Search Console (dans Outils hérités) vous permet d’indiquer à Google comment traiter des paramètres spécifiques. Vous pouvez spécifier que ?sort= ou ?session_id= ne modifie pas le contenu de la page, ce qui aide Google à consolider les URL paramétrées sous la version canonique. Utilisez cet outil avec précaution — une mauvaise configuration peut amener Google à ignorer des paramètres qui produisent effectivement un contenu différent.
Création de contenu unique
La solution la plus durable contre le contenu dupliqué est de créer des pages véritablement distinctes. Pour les affiliés, cela signifie rédiger des avis produits originaux, des comparatifs et des guides plutôt que de republier les descriptions des fabricants. Pour les sites e-commerce, cela signifie ajouter des photos de produits uniques, des questions-réponses clients et des guides d’achat originaux. Les moteurs de recherche récompensent le contenu qui apporte une valeur ajoutée par rapport à ce qui existe déjà ailleurs.
Contenu dupliqué dans le marketing d’affiliation
Les affiliés sont confrontés à un défi unique en matière de contenu dupliqué : ils font la promotion de produits que des centaines ou des milliers d’autres affiliés promeuvent également, souvent en utilisant les mêmes descriptions, images et spécifications fournies par les fabricants.
Le problème pour les affiliés
Lorsqu’un affilié copie une description de produit depuis le site du marchand et la publie textuellement, il rejoint un groupe de pages identiques en compétition pour les mêmes mots-clés. Google voit des dizaines ou des centaines de pages avec le même texte et doit en choisir une — ou aucune — à classer. La page produit du marchand, avec son autorité de domaine plus élevée, gagne presque toujours. La page de l’affilié coule.
Ce n’est pas une pénalité. C’est un problème de pertinence et d’autorité : un contenu identique n’apporte rien de nouveau au web, donc les moteurs de recherche n’ont aucune raison d’afficher plusieurs copies de celui-ci.
Solutions pratiques pour les affiliés
Rédigez des avis produits originaux. Au lieu de répéter la liste de fonctionnalités du fabricant, décrivez votre expérience pratique avec le produit. Qu’est-ce qui vous a surpris ? Qu’avez-vous trouvé frustrant ? Comment se compare-t-il aux alternatives que vous avez testées ? Les détails de première main ne peuvent être dupliqués par personne d’autre.
Ajoutez une valeur unique au-delà de la description produit. Incluez des photos originales, des vidéos de démonstration, des tableaux comparatifs que vous avez créés vous-même, des scénarios d’utilisation et des réponses aux questions que la page du fabricant ne traite pas.
Utilisez des balises canoniques lors de la syndication. Si vous publiez un contenu qui apparaît également sur le site de votre marchand ou sur un blog partenaire, ajoutez une balise canonique pointant vers la version que vous souhaitez voir classée. Coordonnez-vous avec votre responsable de programme d’affiliation pour convenir de l’URL canonique.
Évitez les stratégies de pages passerelles. Créer des dizaines de pages quasi identiques ciblant de légères variations de mots-clés — autrefois une tactique courante pour les affiliés — est explicitement contraire aux directives de Google et risque une suppression algorithmique. Une page complète traitant un sujet en profondeur surpassera dix variations légères.
Le rôle du responsable de programme
Les responsables de programmes d’affiliation peuvent réduire les problèmes de contenu dupliqué au sein de leur réseau d’affiliés en :
- Encourageant les affiliés à rédiger des avis originaux plutôt que de copier-coller le texte fourni
- Fournissant des conseils sur les balises canoniques afin que les affiliés sachent vers quelle URL pointer lorsqu’ils utilisent du contenu partagé
- Surveillant les pages des meilleurs affiliés pour détecter tout contenu léger ou dupliqué et en offrant des commentaires constructifs
Le point de vue de l’annonceur
Les marchands et annonceurs qui gèrent des programmes d’affiliation bénéficient lorsque leurs affiliés publient un contenu unique et de haute qualité. Cela élargit l’empreinte de recherche de la marque sur davantage de mots-clés et de requêtes que le seul site du marchand ne pourrait capturer. Le contenu dupliqué des affiliés, en revanche, n’ajoute aucune présence de recherche supplémentaire et peut créer une impression de marque négative lorsque les internautes rencontrent le même texte sur des dizaines de sites de faible qualité. Investir dans la formation des affiliés et dans des supports créatifs uniques génère un dividende SEO direct.
Quelle quantité de contenu dupliqué est acceptable ?
Il n’existe pas de seuil officiel en dessous duquel le contenu dupliqué est « sûr ». Google n’utilise pas un score de duplication qui déclenche une action à un certain niveau. La question est plutôt de savoir si chaque page apporte une valeur incrémentale.
La norme pratique : si vous n’êtes pas sûr de pouvoir expliquer à un internaute pourquoi cette page mérite d’exister séparément de pages similaires sur votre site ou ailleurs, elle est probablement trop légère pour justifier sa propre URL.