

Robot de moteur de recherche
Un robot de moteur de recherche est un programme automatisé qui parcourt les pages web pour indexer le contenu des moteurs de recherche comme Google et Bing. Dé...
13 min de lecture
SEO
DigitalMarketing
+3
+++ term = “Qu’est-ce qu’un robot d’exploration de moteur de recherche ?” lastmod = “2026-10-08” title = “Qu’est-ce qu’un robot d’exploration de moteur de recherche ?” keywords = [ “classement moteur de recherche”, “moteur de recherche”, “classement moteur”, “optimisation pour moteurs de recherche”, “rôle dans la recherche”, “robots d’exploration”, “recherche”, “moteur” ] url = “/glossaire-du-marketing-d-affiliation/crawlers/” aliases = [ “/affiliate-marketing-glossary/crawlers/” ] description = “Découvrez comment les robots d’exploration des moteurs de recherche découvrent et indexent les pages web et pourquoi cela compte pour le SEO.” date = “2024-11-07 11:14:13” image = "" shortDescription = “Un robot d’exploration de moteur de recherche est un programme logiciel automatisé — également appelé bot, spider ou spiderbot — qui parcourt systématiquement le World Wide Web, télécharge le contenu des pages et suit les hyperliens pour découvrir des URL nouvelles ou mises à jour.” tags = [ “SEO”, “Crawlers”, “Indexing”, “AffiliateMarketing”, “SearchEngines”, “TechnicalSEO” ] categories = [ “Glossary” ] showCTA = true ctaHeading = “Optimisez votre site pour les moteurs de recherche” ctaDescription = “Découvrez comment comprendre les robots d’exploration et optimiser votre site pour eux peut améliorer la visibilité et le classement de votre site dans les moteurs de recherche.” ctaPrimaryText = “Obtenez des conseils SEO” ctaPrimaryURL = “/blog/” ctaSecondaryText = “Essayez Post Affiliate Pro” ctaSecondaryURL = “/trial/”
[[faq]] question = “Pouvez-vous me donner un exemple de robot d’exploration web ?” answer = “Googlebot est l’exemple le plus connu. Il s’agit du robot d’exploration principal de Google, chargé de découvrir et d’indexer des milliards de pages sur le web. Parmi les autres exemples, citons Bingbot (Microsoft Bing), DuckDuckBot (DuckDuckGo), YandexBot (Yandex) et Baiduspider (Baidu). Du côté de l’IA, GPTBot d’OpenAI et Claude-Web d’Anthropic sont des robots d’exploration qui collectent des données publiquement accessibles pour l’entraînement des modèles.”
[[faq]] question = “Qu’est-ce que le budget d’exploration et pourquoi est-ce important ?” answer = “Le budget d’exploration correspond au nombre de pages qu’un moteur de recherche va explorer sur un site au cours d’une période donnée. Il est déterminé par la limite de vitesse d’exploration (la rapidité avec laquelle le moteur peut récupérer les pages sans nuire aux performances) et la demande d’exploration (à quel point le moteur souhaite explorer le site en fonction de sa popularité et de sa fraîcheur). Les grands sites comptant des milliers de pages doivent gérer leur budget d’exploration avec soin — le gaspiller sur du contenu en double, des URL de navigation à facettes ou des pages d’erreur signifie que des pages à forte valeur ajoutée risquent de ne jamais être visitées.”
[[faq]] question = “Comment vérifier si mon site web a été exploré ?” answer = “Les méthodes les plus fiables sont les suivantes :
[[faq]] question = “Puis-je bloquer un robot d’exploration sans affecter mon SEO ?” answer = “Oui. Utilisez des directives robots.txt ciblant des user-agents spécifiques. Par exemple, bloquer GPTBot n’affecte pas Googlebot, Bingbot ni aucun autre robot de recherche. La clé est la spécificité — utilisez User-agent: GPTBot (pas User-agent: *) lorsque vous souhaitez bloquer un seul robot tout en laissant l’accès aux moteurs de recherche intact. Testez toujours les modifications de robots.txt dans Google Search Console avant de les déployer en production.”
[[faq]] question = “Comment les entreprises d’IA comme OpenAI utilisent-elles les robots d’exploration ?” answer = “Les entreprises d’IA déploient des robots d’exploration comme GPTBot pour collecter des données web publiquement accessibles afin d’entraîner des modèles de langage de grande taille et de permettre la récupération d’informations en temps réel. Ces robots suivent les mêmes mécanismes de base que les robots d’exploration des moteurs de recherche — récupération de pages, suivi de liens et respect de robots.txt — mais leur objectif est l’entraînement de modèles plutôt que l’indexation de recherche.”
[[lnks]] text = “indexation mobile-first” path = “/blog/mobile-friendliness-affiliate-marketing/” title = “Pourquoi la compatibilité mobile est un véritable facteur de classement et de revenus dans le marketing d’affiliation, des Core Web Vitals au design responsive, et comment tester et optimiser votre site d’affiliation pour le mobile.”
[[lnks]] text = “pages web explorées par les robots” path = “/faq/why-are-web-crawlers-called-spiders/” title = “Découvrez pourquoi les robots d’exploration sont appelés spiders, comment ils fonctionnent et leur rôle essentiel dans l’indexation des moteurs de recherche. Explorez les mécanismes techniques derrière l’exploration web en 2025.”
[[lnks]] text = “budget pour chacun” path = “/blog/optimize-affiliate-marketing-budget/” title = “six stratégies actionnables pour optimiser votre budget de marketing d’affiliation, notamment l’exploitation des réseaux sociaux et la collaboration avec des influenceurs de niche”
[[lnks]] text = “Contenu frais et pertinent” path = “/faq/keep-content-fresh-engaging/” title = “Découvrez des stratégies efficaces pour garder votre contenu frais et engageant. Apprenez-en davantage sur les formats de contenu, les analyses, l’engagement du public et les techniques d’écriture professionnelle pour maintenir l’intérêt et réussir dans le marketing d’affiliation.”
[[lnks]] text = “marketeurs d’affiliation” path = “/faq/what-makes-affiliate-marketing-content-rank-well/” title = “Découvrez les facteurs essentiels qui permettent au contenu de marketing d’affiliation de bien se classer dans les moteurs de recherche. Apprenez des stratégies SEO éprouvées, des techniques d’optimisation de contenu et des bonnes pratiques pour améliorer la visibilité et les conversions de votre site d’affiliation.”
[[lnks]] text = “Optimisation des mots-clés” path = “/faq/how-to-do-on-page-seo/” title = “Apprenez à optimiser le SEO on-page avec les balises titre, les méta-descriptions, les en-têtes, les mots-clés et les stratégies de contenu. Maîtrisez l’optimisation technique on-page pour améliorer les classements de recherche avec le guide complet de PostAffiliatePro.”
[[lnks]] text = “Marketeurs d’affiliation” path = “/blog/top-keyword-research-tools-for-affiliate-marketers/” title = “Quels outils de recherche de mots-clés les marketeurs d’affiliation devraient-ils utiliser pour que leur contenu soit mieux classé dans Google ? Lisez cet article pour le savoir !”
[[lnks]] text = “Liens d’affiliation” path = “/affiliate-marketing-glossary/seo-affiliates/” title = “Les affiliés SEO, également appelés affiliés de recherche, vous aident à améliorer le classement de votre site dans les pages de résultats de recherche. Découvrez comment les affiliés SEO utilisent des stratégies expertes pour générer du trafic organique et stimuler le succès du marketing d’affiliation.”
[[lnks]] text = “Robots d’exploration” path = “/faq/how-do-web-crawlers-work/” title = “Découvrez comment fonctionnent les robots d’exploration web, des URL de départ à l’indexation. Comprenez le processus technique, les types de robots, les règles robots.txt et l’impact des robots d’exploration sur le SEO et le marketing d’affiliation.”
[[lnks]] text = “affecter le SEO” path = “/faq/why-are-sitemaps-important/” title = “Découvrez pourquoi les plans de site sont essentiels pour réussir en SEO. Apprenez comment les plans de site XML et HTML améliorent la capacité d’exploration, l’indexation et la visibilité de votre site dans les moteurs de recherche.”
[[lnks]] text = “moteurs de recherche” path = “/faq/how-to-identify-search-engine-crawlers/” title = “Apprenez à identifier les robots d’exploration des moteurs de recherche à l’aide des chaînes user-agent, des adresses IP, des modèles de requêtes et de l’analyse comportementale. Guide essentiel pour les webmasters et les développeurs.”
[[lnks]] text = “essentiel pour la recherche” path = “/faq/what-is-google-spider/” title = “Découvrez ce qu’est Google Spider (Googlebot), comment il explore et indexe les sites web, et pourquoi il est indispensable pour le SEO. Apprenez à optimiser votre site pour une meilleure exploration.” +++ Un robot d’exploration de moteur de recherche est un programme logiciel automatisé — également appelé bot, spider ou spiderbot — qui parcourt systématiquement le World Wide Web, télécharge le contenu des pages et suit les hyperliens pour découvrir des URL nouvelles ou mises à jour. Son rôle principal est d’alimenter l’index d’un moteur de recherche avec des données fraîches afin que, lorsqu’une personne effectue une requête, le moteur puisse renvoyer des résultats pertinents et actuels. Sans robots d’exploration, un moteur de recherche ne peut même pas savoir qu’une page existe.
Le robot d’exploration lui-même ne classe rien. Il découvre et transmet ce qu’il trouve — texte, liens, métadonnées, images — à un système distinct d’indexation et de classement. L’exploration, l’indexation et le classement sont trois étapes distinctes. Une page peut être explorée et ne jamais apparaître dans les résultats de recherche si elle ne répond pas aux seuils de qualité du moteur lors de l’indexation.
La documentation de Google sur les robots d’exploration distingue ses robots courants, ses robots spéciaux et ses récupérateurs déclenchés par l’utilisateur. Consultez l’identité et le comportement documentés du robot concerné lorsque vous étudiez des problèmes d’accès.
Sur cette page
Un robot d’exploration web fonctionne selon une boucle continue articulée autour de quelques étapes clés. Comprendre ces étapes aide les propriétaires de sites à diagnostiquer pourquoi certaines pages peuvent ne pas apparaître dans les résultats de recherche — le problème se situe souvent au stade de l’exploration, bien avant que le classement ne soit même pris en compte.
Chaque robot d’exploration commence par un ensemble d’URL connues appelées URL de départ. Celles-ci peuvent provenir de pages déjà explorées, de plans de site soumis ou de points de départ sélectionnés manuellement. Le robot télécharge chaque page de départ, extrait chaque hyperlien qu’il trouve et ajoute tout lien qu’il n’a pas encore vu à une file d’attente appelée frontière d’exploration (crawl frontier).
Le cycle se répète ensuite :
Cette boucle ne se termine jamais vraiment. Le web change constamment et de nouvelles pages apparaissent chaque seconde, donc un robot d’exploration se contente de traiter ce qui suit dans la file d’attente, en revisitant les anciennes pages pour détecter les changements et en ajoutant les URL nouvellement découvertes.
Une fois qu’un robot d’exploration récupère une page, il en effectue le rendu — en lisant le HTML, en exécutant JavaScript lorsque c’est possible, et en extrayant le texte, les images, les métadonnées et les données structurées. Il télécharge ensuite ces informations et les transmet à l’indexeur du moteur de recherche.
Tous les robots d’exploration ne gèrent pas JavaScript de manière égale. Googlebot exécute JavaScript et attend le chargement du contenu dynamique, mais les robots d’exploration de moteurs de recherche plus petits peuvent ne lire que le HTML statique. C’est pourquoi les sites entièrement construits avec des frameworks JavaScript côté client peuvent être invisibles pour certains moteurs de recherche, à moins qu’un rendu côté serveur ne soit en place.
Les robots d’exploration découvrent de nouvelles pages par deux canaux principaux :

Configurez le suivi avancé en quelques minutes. Aucune carte de crédit requise.
Les robots d’exploration ne traitent pas toutes les pages de la même manière. Ils fonctionnent selon un ensemble de politiques d’exploration qui déterminent les pages à visiter, dans quel ordre et à quelle fréquence revenir.
Un robot d’exploration doit décider quelles URL prioriser dans sa frontière d’exploration. Les signaux courants incluent :
La fréquence à laquelle un robot d’exploration revient sur une page dépend de la fréquence à laquelle cette page change. La page d’accueil d’un site d’actualités peut être explorée toutes les quelques minutes. Une page statique « À propos » peut être revisitée une fois tous les quelques mois. Les webmasters peuvent signaler la fréquence de changement via les balises <changefreq> du plan de site XML, bien que les moteurs de recherche les traitent comme des indications, et non des ordres.
Les robots d’exploration sont programmés pour éviter de surcharger les serveurs web. Ils respectent une limite de vitesse d’exploration — le nombre maximal de requêtes qu’ils enverront à un même site dans une période donnée. Si un serveur répond avec des erreurs HTTP comme 500 ou 503, le robot réduit sa cadence pour ne pas aggraver le problème. Cela fait partie de ce qui fait de l’exploration à grande échelle un véritable défi d’ingénierie.
Le fichier robots.txt est un document texte placé à la racine d’un domaine qui indique aux robots d’exploration quelles URL ils peuvent ou ne peuvent pas demander. C’est l’outil le plus important pour gérer l’accès des robots d’exploration. Une entrée robots.txt peut ressembler à ceci :
User-agent: Googlebot
Disallow: /private/
Allow: /public/
/private/ mais d’autoriser tout ce qui se trouve sous /public/. Les autres robots consultent le même fichier et suivent leurs propres directives User-agent. Il convient de noter que le robots.txt est un protocole volontaire — les robots d’exploration bien élevés l’obéissent, mais les bots malveillants peuvent l’ignorer complètement.Le budget d’exploration correspond au nombre de pages qu’un moteur de recherche explorera sur un site dans un laps de temps donné. Il est déterminé par deux facteurs :
Pour les petits sites, le budget d’exploration est rarement un problème. Pour les grandes plateformes de commerce électronique ou les sites de contenu comptant des millions d’URL, la gestion du budget d’exploration devient essentielle — des explorations gaspillées sur du contenu en double, des paramètres de navigation à facettes ou des pages de faible valeur signifient moins de ressources pour les pages qui comptent.
Chaque moteur de recherche majeur exploite son propre robot d’exploration avec une chaîne user-agent distincte — un identifiant que le bot envoie avec chaque requête HTTP afin que les serveurs sachent quel robot les visite.
| Moteur de recherche | Nom du robot | Identifiant User-Agent | Objectif |
|---|---|---|---|
| Googlebot | Googlebot/2.1 | Explore et indexe les pages web pour Google Search et autres services Google | |
| Bing | Bingbot | Mozilla/5.0 (compatible; bingbot/2.0) | Explore et indexe les pages pour Microsoft Bing |
| DuckDuckGo | DuckDuckBot | DuckDuckBot/1.0 | Explore les pages pour les résultats de recherche DuckDuckGo |
| Yandex | YandexBot | Mozilla/5.0 (compatible; YandexBot/3.0) | Explore les pages pour Yandex Search (dominant en Russie) |
| Baidu | Baiduspider | Mozilla/5.0 (compatible; Baiduspider/2.0) | Explore les pages pour Baidu Search (dominant en Chine) |
| Apple | Applebot | Applebot/1.0 | Explore les pages pour Spotlight Search et les suggestions Siri |
Google exploite également des robots spécialisés pour différents types de contenu — Googlebot Image explore les images, Googlebot Video traite le contenu vidéo, Googlebot News cible les articles d’actualité, et AdsBot vérifie la qualité des pages de destination pour Google Ads.
Soyez le premier à connaître les nouvelles fonctionnalités et mises à jour.
Identifier si un visiteur est véritablement Googlebot nécessite plus qu’une simple vérification de la chaîne user-agent, car ces chaînes peuvent être usurpées. Pour vérifier un robot Google :
Googlebot.googlebot.com ou google.com.Google fournit une documentation officielle répertoriant ses plages d’adresses IP sur google.com/bot.html. Tout visiteur prétendant être Googlebot qui échoue à ces étapes de vérification est un bot usurpé et doit être traité comme suspect.
Oui — mais avec des limites. Les principaux moteurs de recherche exploitent des robots d’exploration dédiés au contenu non textuel :
VideoObject pour comprendre le titre, la description, la vignette et la durée.Cependant, les robots d’exploration ne peuvent pas « voir » les images comme le ferait un humain ni « regarder » une vidéo. Ils s’appuient entièrement sur des signaux textuels — noms de fichiers, attributs alt, légendes, texte environnant et données structurées — pour déterminer la pertinence. Le contenu verrouillé derrière des murs de connexion, des paywalls ou intégré dans des lecteurs JavaScript complexes peut ne pas être exploré du tout.
Ces termes sont souvent utilisés de manière interchangeable, mais ils décrivent des choses différentes :
| Aspect | Robot d’exploration web | Scraper web |
|---|---|---|
| Objectif | Découvrir et indexer des URL sur l’ensemble du web | Extraire des données spécifiques de pages ciblées |
| Périmètre | Large — suit les liens partout | Étroit — cible des URL ou domaines connus |
| Résultat | Alimente un index de recherche | Produit des données structurées (CSV, base de données, tableur) |
| Opérateur typique | Moteurs de recherche (Google, Bing) | Entreprises, chercheurs, analystes de données |
| Respecte robots.txt | Oui (robots légitimes) | Variable — de nombreux scrapers l’ignorent |
| Exemples | Googlebot, Bingbot | Outils de surveillance des prix, scrapers de génération de leads, collecteurs de données d’entraînement pour l’IA |
Les moteurs de recherche trouvent de nouvelles pages via plusieurs canaux :
Le moyen le plus rapide de faire explorer une nouvelle page est de soumettre son URL directement via Search Console et de s’assurer qu’elle est liée depuis une page déjà indexée sur le même site.
Il n’existe pas de calendrier fixe. La fréquence de revisite dépend de :
Les propriétaires de sites peuvent influencer la fréquence de revisite en publiant du contenu régulièrement, en maintenant des temps de réponse rapides et en soumettant des plans de site mis à jour. Mais en fin de compte, le robot d’exploration décide de son propre calendrier en fonction des signaux qu’il observe.
Les robots d’exploration ne peuvent généralement pas accéder :
Un robot d’exploration ne voit que ce qui est publiquement accessible et lié. Si une page nécessite une authentification ou une interaction utilisateur pour s’afficher, elle est effectivement invisible pour les moteurs de recherche — à moins que le propriétaire du site n’accorde explicitement l’accès ou ne fournisse un chemin alternatif, comme un plan de site répertoriant l’URL combiné à des données structurées décrivant le contenu.
Construire un robot d’exploration qui fonctionne pour quelques centaines de pages est simple. En construire un qui fonctionne pour des milliards de pages est un problème complètement différent. Les points de défaillance courants incluent :
Pour la plupart des entreprises, exploiter un robot d’exploration web à grande échelle n’est pas pratique sans une infrastructure gérée. La décision revient généralement à utiliser un outil existant plutôt que de tout construire de zéro.
Aux États-Unis, l’exploration de pages web publiquement accessibles est généralement légale. Plusieurs décisions de justice — dont *hiQ Labs c.
Cependant, la légalité dépend de plusieurs facteurs :
La distinction entre l’exploration pour l’indexation de recherche (largement acceptée) et le scraping pour l’extraction commerciale de données (plus contestée sur le plan juridique) est importante. La plupart des robots d’exploration légitimes des moteurs de recherche opèrent dans un cadre clairement légal.
Non — ChatGPT lui-même n’est pas un robot d’exploration web. ChatGPT est un modèle d’IA conversationnelle qui génère des réponses. Cependant, OpenAI exploite un robot d’exploration web distinct appelé GPTBot, qui explore les pages web publiques pour collecter des données d’entraînement pour les modèles d’IA et pour prendre en charge des fonctionnalités de récupération en direct dans certains produits OpenAI.
GPTBot s’identifie avec le jeton user-agent GPTBot et respecte les directives robots.txt. Les propriétaires de sites qui souhaitent bloquer spécifiquement GPTBot peuvent ajouter ce qui suit à leur fichier robots.txt :
User-agent: GPTBot
Disallow: /
Les robots d’exploration des moteurs de recherche affectent directement tous les acteurs de l’écosystème du marketing d’affiliation. Si une page n’est pas explorée, elle n’est pas classée, et si elle n’est pas classée, elle ne génère aucun trafic organique — et donc aucun revenu d’affiliation.
Le site de contenu d’un éditeur repose entièrement sur sa capacité à être exploré. Chaque avis de produit, guide comparatif ou tour d’horizon des offres doit être découvrable par les robots d’exploration. Les erreurs courantes des éditeurs qui bloquent l’exploration incluent :
Les éditeurs doivent vérifier que leurs pages les plus importantes apparaissent dans le rapport de couverture d’index de Google Search Console et qu’aucune balise noindex ni règle robots.txt ne les bloque involontairement.
Un annonceur qui gère un programme d’affiliation a besoin que ses pages produits soient explorées et indexées afin que les éditeurs puissent créer des liens vers des pages visibles et actives. Si les pages produits d’un commerçant ne sont pas dans l’index de Google, les éditeurs n’ont nulle part où envoyer le trafic. Les risques spécifiques incluent :
Les commerçants doivent maintenir des structures d’URL propres, soumettre des plans de site produits et surveiller les statistiques d’exploration dans Search Console pour détecter les problèmes avant qu’ils n’affectent leurs partenaires éditeurs.
Les gestionnaires de programmes se situent entre les commerçants et les éditeurs et doivent comprendre le comportement des robots d’exploration pour résoudre les problèmes de visibilité. Lorsqu’un éditeur signale qu’une page produit d’un commerçant « n’apparaît pas dans Google », le problème est souvent lié à l’exploration ou à l’indexation — pas au classement. Les mesures pratiques incluent :
site: de Google.Un gestionnaire de programme capable de diagnostiquer les problèmes d’exploration de base apporte une valeur ajoutée directe aux deux parties de la relation d’affiliation — en aidant les commerçants à résoudre les problèmes techniques et en aidant les éditeurs à confirmer que les pages qu’ils promeuvent sont trouvables.
Gérez plusieurs programmes d'affiliation et améliorez les performances de vos partenaires affiliés avec Post Affiliate Pro.
Un robot de moteur de recherche est un programme automatisé qui parcourt les pages web pour indexer le contenu des moteurs de recherche comme Google et Bing. Dé...

Découvrez ce qu’est le Google Spider (Googlebot), comment il explore et indexe les sites web, et pourquoi il est essentiel pour le SEO. Apprenez à optimiser vot...
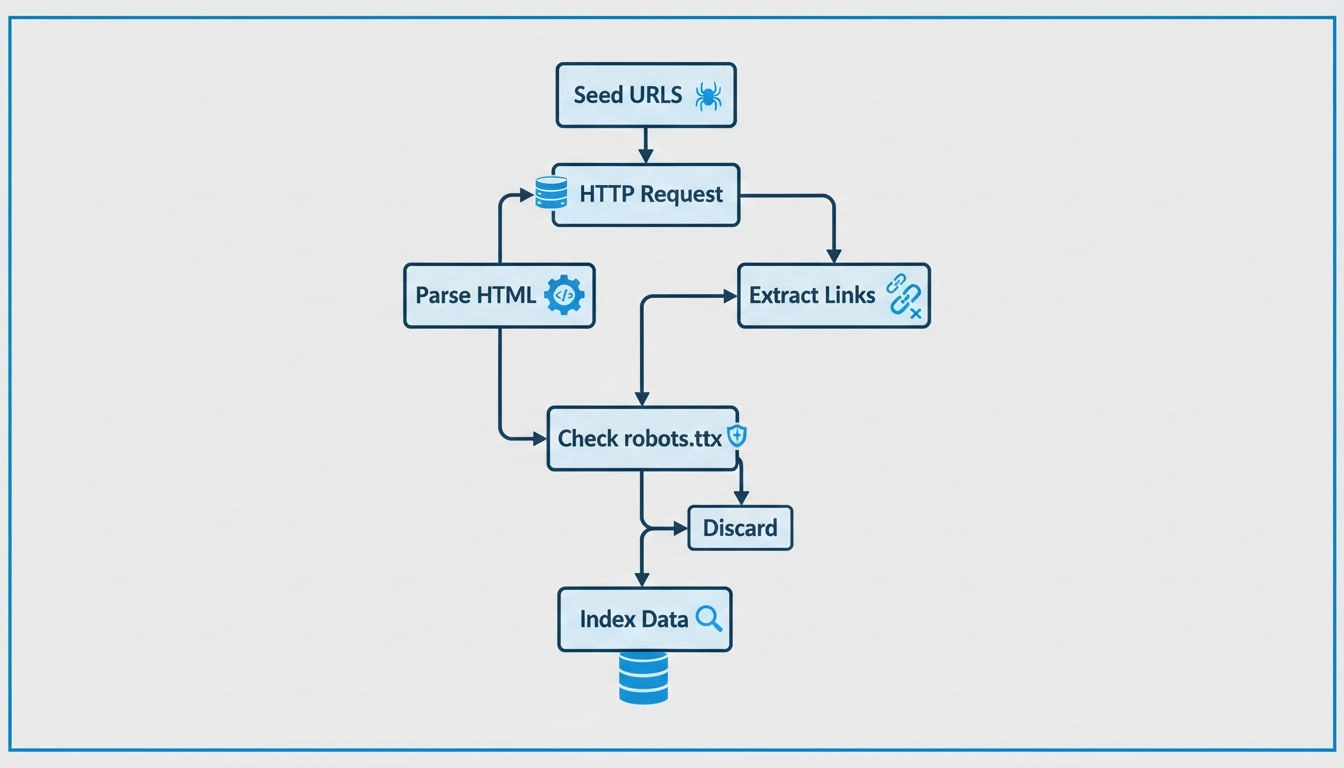
Découvrez comment fonctionnent les crawlers web, des URLs sources à l'indexation. Comprenez le processus technique, les types de crawlers, les règles robots.txt...
Rejoignez notre communauté de clients satisfaits et offrez un excellent support client avec Post Affiliate Pro.


Consentement aux Cookies
Nous utilisons des cookies pour améliorer votre expérience de navigation et analyser notre trafic. See our privacy policy.