


Fonctionnalité API
Qu'est-ce qu'une API en termes simples, comment pouvez-vous l'utiliser dans Post Affiliate Pro, et quels avantages cela apporte-t-il à votre entreprise ?
3 min de lecture
API
Tracking
+5
Une interface de programmation d’application (API) est un contrat défini entre deux composants logiciels qui précise la manière dont ils communiquent.
Pour les intégrations côté navigateur, la référence des API web de MDN documente les interfaces disponibles pour le code des sites web. Celles-ci diffèrent de l’API propre d’une plateforme d’affiliation, dont l’authentification, les points de terminaison et les limites doivent être vérifiés dans la documentation de cette plateforme.
On this page
Une interface de programmation d’application (API) est un contrat défini entre deux composants logiciels qui précise comment ils communiquent. Un composant envoie une requête dans un format structuré ; l’autre renvoie une réponse avec les données demandées ou exécute l’action demandée.
La définition comporte trois éléments importants :
Point crucial : une API n’est pas une interface utilisateur. Les utilisateurs finaux ne la voient jamais. Lorsqu’un acheteur clique sur « Payer avec PayPal » sur un site de commerce électronique et voit un écran de confirmation quelques secondes plus tard, l’API a géré la liaison entre la boutique et les serveurs de PayPal — mais l’acheteur n’en a vu que le résultat.

Configurez le suivi avancé en quelques minutes. Aucune carte de crédit requise.
API signifie Application Programming Interface (interface de programmation d’application). Décomposons-le :
| Composant | Ce que cela signifie |
|---|---|
| Application | Tout programme logiciel ayant une fonction définie — une application mobile, un service web, une base de données, un composant de système d’exploitation |
| Programmation | L’interaction se fait par le code, et non par des boutons ou des menus. Les développeurs écrivent des instructions qui appellent les méthodes exposées par l’API. |
| Interface | La frontière partagée. Elle définit ce qui peut être demandé et comment, sans révéler comment le système sous-jacent exécute la requête. |
Le terme est utilisé depuis au moins les années 1960, mais il est entré dans le vocabulaire courant du logiciel avec l’essor des API web au début des années 2000. Aujourd’hui, lorsque la plupart des gens disent « API » sans précision, ils veulent dire une API web — une API qui communique sur Internet à l’aide de HTTP.
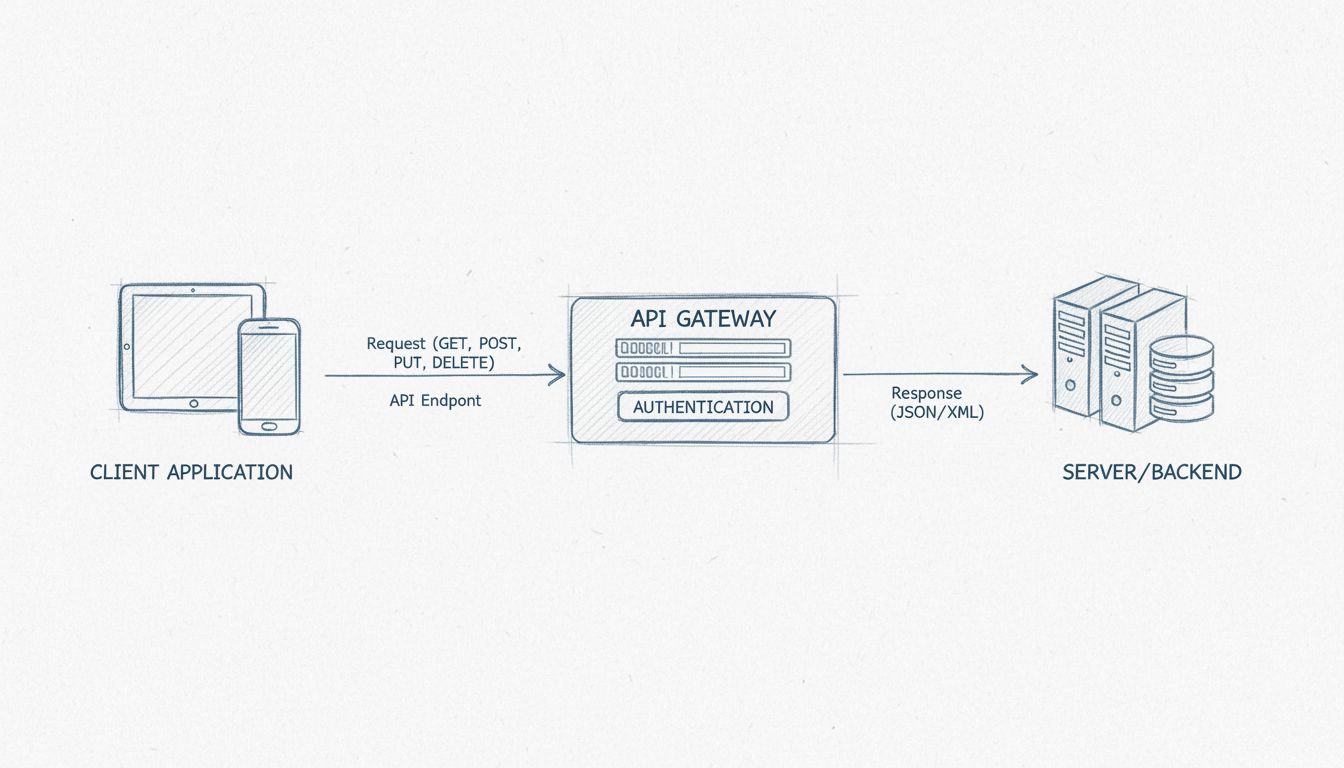
La communication API suit un modèle requête-réponse client-serveur. Voici le cycle de vie d’un appel API unique :
L’application cliente initie une requête. Un développeur écrit du code qui envoie une requête HTTP à un point de terminaison API spécifique — une URL qui représente une ressource ou une action. La requête comprend une méthode (GET, POST, PUT, DELETE), des en-têtes (des métadonnées comme les jetons d’authentification) et éventuellement un corps (la charge utile, souvent au format JSON).
L’API reçoit et valide la requête. Le serveur vérifie que la requête est bien formée, que les identifiants d’authentification sont valides et que le client est autorisé à effectuer l’opération demandée.
Le serveur traite la requête. Cela peut impliquer l’interrogation d’une base de données, l’appel d’un autre service interne, la transformation de données ou le déclenchement d’un processus métier. La couche API abstrait tout cela du client.
Le serveur renvoie une réponse. La réponse comprend un code de statut HTTP (200 pour le succès, 404 pour introuvable, 500 pour une erreur serveur, etc.), des en-têtes de réponse et généralement un corps contenant les données demandées ou un message de confirmation — couramment formaté en JSON ou XML.
L’application cliente consomme la réponse. Le code appelant analyse les données et les utilise — mise à jour d’un affichage, enregistrement d’une donnée, déclenchement de l’étape suivante d’un flux de travail.
Un exemple concret : une application météo sur votre téléphone envoie une requête comme GET /weather?city=Dallas à l’API d’un service météorologique. L’API interroge ses sources de données, construit une réponse JSON avec la température, l’humidité et les prévisions, puis la renvoie. L’application analyse ce JSON et affiche « 82°F, partiellement nuageux ». L’application n’a jamais besoin de savoir comment le service météorologique collecte ou stocke ses données — elle n’a qu’à suivre le contrat de l’API.
https://api.weatherservice.com/v2/weather?city=Dallas&units=imperialSoyez le premier à connaître les nouvelles fonctionnalités et mises à jour.
Un point de terminaison API (endpoint) est une URL (ou URI) spécifique au sein d’une API qui correspond à une ressource ou une opération particulière. Alors que l’API est l’interface complète, un point de terminaison est un point de contact adressable au sein de celle-ci.
Par exemple, une API de marketing d’affiliation hypothétique pourrait exposer ces points de terminaison :
| Point de terminaison | Méthode | Ce qu’il fait |
|---|---|---|
/commissions | GET | Récupère une liste de commissions |
/commissions/{id} | GET | Récupère une commission unique par ID |
/commissions | POST | Crée un nouvel enregistrement de commission |
/affiliates/{id}/earnings | GET | Renvoie les gains totaux d’un affilié spécifique |
/clicks | POST | Enregistre un événement de clic pour le suivi |
Chaque point de terminaison représente une capacité distincte. Les API bien conçues utilisent une dénomination cohérente et prévisible des points de terminaison afin que les développeurs puissent raisonner sur l’interface sans consulter constamment la documentation. Ce modèle — traiter les URL comme des ressources et utiliser les méthodes HTTP pour décrire les actions — est le fondement de la conception des API REST.
Les points de terminaison sont importants car ils définissent la granularité de ce que vous pouvez demander au système. Une API avec des points de terminaison bien conçus permet aux développeurs de composer des flux de travail complexes à partir d’appels simples et réutilisables. Une API avec des points de terminaison mal conçus force les développeurs à contourner les problèmes — effectuer plusieurs appels pour assembler des données qui auraient dû être disponibles en un seul, ou analyser des réponses surdimensionnées pour trouver le seul champ dont ils ont besoin.
Les API peuvent être classées de deux manières : par niveau d’accès (qui peut les utiliser) et par couche technique (où elles opèrent dans la pile logicielle).
| Type | Qui y a accès | Cas d’utilisation courants |
|---|---|---|
| API publiques (ouvertes) | Tout développeur externe, souvent avec une clé API | Données météo, horaires de transports publics, partage sur les réseaux sociaux, passerelles de paiement |
| API partenaires | Des partenaires commerciaux spécifiques sous contrat | Échange de données B2B, intégration fournisseurs, services co-marqués |
| API privées (internes) | Uniquement les équipes de développement internes | Connexion de microservices, synchronisation de bases de données internes, automatisation de flux de travail internes |
| API composites | Les clients autorisés ayant besoin d’opérations par lots | Combiner plusieurs appels API en une seule requête pour réduire les allers-retours et améliorer les performances |
Les API publiques — parfois appelées API ouvertes — constituent la catégorie la plus visible. Des entreprises comme Google (Maps), Stripe (paiements) et OpenAI (ChatGPT) exposent des API publiques que tout développeur peut intégrer après avoir enregistré des identifiants. Le modèle économique varie : certaines sont gratuites avec des limites de débit, d’autres facturent par appel, et d’autres encore favorisent l’adoption d’une plateforme.
Les API partenaires se situent entre les API publiques et privées. Elles sont exposées à des partenaires commerciaux spécifiques selon des conditions négociées. Un réseau d’affiliation, par exemple, pourrait exposer une API partenaire permettant aux annonceurs approuvés d’interroger les données de commissions par programmation — mais cette même API n’est pas disponible pour le grand public.
Les API privées — également appelées API internes — sont utilisées exclusivement au sein d’une organisation. L’application mobile d’une entreprise peut communiquer avec son backend via une API privée qu’un utilisateur public ne pourrait jamais découvrir. Ces API privilégient la productivité des développeurs internes et la sécurité par rapport à l’utilisabilité générale.
Les API composites répondent à un problème de performance : lorsqu’une seule action utilisateur nécessite des données de cinq services différents, effectuer cinq appels API distincts ajoute de la latence. Une API composite regroupe ces requêtes en un seul appel et renvoie une réponse unifiée. Elles sont courantes dans les architectures de microservices et les configurations de passerelles API.
requests et appelle requests.get() utilise une API de bibliothèque. Aucun réseau n’est impliqué.psycopg2 pour PostgreSQL entrent dans cette catégorie.Toutes les API web ne sont pas construites de la même manière. Le protocole — parfois appelé style architectural — définit comment les requêtes et les réponses sont structurées, quels formats elles utilisent et quelles contraintes elles suivent.
Avantages des API REST :
curlLimites de REST :
SOAP est un protocole plus ancien, basé sur XML, antérieur à REST. Il est plus rigide : les messages doivent se conformer à un schéma XML strict, et le protocole définit ses propres règles de sécurité et de transactions via les normes WS-*.
SOAP est encore utilisé dans les environnements d’entreprise — services financiers, traitement des paiements et systèmes gouvernementaux — où sa sécurité intégrée, l’intégrité des transactions et les contrats formels (fichiers WSDL) comptent plus que la simplicité de REST. SOAP est une infrastructure héritée qui persiste, et non une technologie que les équipes choisissent pour les projets greenfield.
Au lieu que le serveur définisse des points de terminaison fixes avec des formes de réponse fixes, le client spécifie exactement les champs qu’il souhaite dans une seule requête :
query {
  affiliate(id: "4821") {
    name
    totalEarnings
    recentCommissions(limit: 5) {
      amount
      date
      campaign { name }
    }
  }
}
Les API d’appel de procédure à distance (RPC) traitent les opérations côté serveur comme des appels de fonction. Le client appelle createInvoice(customer, amount) et le serveur renvoie le résultat. gRPC, développé par Google, est le framework RPC moderne — il utilise Protocol Buffers pour une sérialisation binaire efficace et est populaire dans les architectures de microservices où la performance prime sur la lisibilité humaine.
Les API WebSocket maintiennent une connexion bidirectionnelle persistante. Contrairement au modèle requête-réponse de REST, WebSocket permet au serveur de pousser des données vers le client sans attendre une requête. C’est essentiel pour les fonctions en temps réel : applications de chat, tableaux de bord en direct, édition collaborative et flux de données en continu.
Une intégration d’API est le processus de connexion de deux ou plusieurs systèmes logiciels via leurs API afin qu’ils puissent échanger des données et déclencher des actions automatiquement. L’intégration définit :
Par exemple, une intégration d’API entre une plateforme de commerce électronique et un système de suivi d’affiliation pourrait fonctionner ainsi : lorsqu’un client termine un achat, la plateforme de commerce envoie une requête POST au point de terminaison /conversions du système de suivi avec les détails de la commande, l’ID de l’affilié et le montant de la commission. Le système de suivi enregistre la conversion et renvoie une confirmation. Aucun humain n’a copié de données entre des tableurs ; aucun fichier CSV n’a été envoyé par e-mail.
L’entreprise moyenne du segment mid-market utilise plus de 100 applications SaaS, et celles qui fonctionnent ensemble sans heurt — grâce à des API documentées et stables — sont celles qui gagnent.
Le marketing d’affiliation repose sur les données : clics, conversions, taux de commissions, calendriers de paiement, indicateurs de performance. Chaque donnée doit circuler entre les systèmes de manière fiable et en quasi temps réel. Les API rendent cela possible.
Les annonceurs utilisent les API pour :
Les éditeurs utilisent les API pour :
Les gestionnaires de programme se situent entre les annonceurs et les éditeurs. Les API leur permettent de :
Les API dans le marketing d’affiliation sont puissantes mais pas magiques :
Une passerelle API est un serveur qui se situe entre les clients et un ensemble de services backend, agissant comme un point d’entrée unique pour toutes les requêtes API. Au lieu d’appeler chaque microservice directement, les clients appellent la passerelle, qui achemine les requêtes, applique les politiques et agrège les réponses.
Une passerelle API gère généralement :
Dans le contexte d’une plateforme d’affiliation, une passerelle API peut gérer l’authentification de milliers d’éditeurs, limiter le débit de clés API individuelles pour prévenir les abus et acheminer différents types de requêtes — appels de suivi, requêtes de reporting, commandes administratives — vers différents services backend — le tout derrière un domaine unique et cohérent comme api.yourplatform.com.
Elles ne sont pas facultatives pour toute plateforme traitant du trafic API de production à grande échelle.
Les API exposent la logique métier et les données au réseau, ce qui en fait une cible de grande valeur. Sécuriser une API implique plusieurs couches :
Authentification. Chaque requête API doit prouver qui l’envoie. Mécanismes courants : clés API (simples mais facilement divulguées), jetons OAuth 2.0 (norme du secteur pour l’accès délégué) et TLS mutuel (basé sur des certificats, courant dans les API B2B et financières).
Autorisation. L’authentification prouve l’identité ; l’autorisation détermine ce que cette identité est autorisée à faire. La clé API d’un éditeur devrait pouvoir interroger ses propres commissions — et celles de personne d’autre. Mettez en œuvre des autorisations à périmètre restreint et validez-les à chaque requête.
Sécurité du transport. Utilisez toujours HTTPS (TLS 1.2 ou supérieur). N’exposez jamais un point de terminaison API en HTTP simple en production. Cela chiffre les données en transit et prévient les attaques de l’homme du milieu.
Validation des entrées. Traitez chaque requête API comme potentiellement malveillante. Validez les types de données, les longueurs de chaînes, les plages numériques et les valeurs d’énumération avant le traitement. Rejetez tout ce qui est inattendu — n’essayez pas de « corriger » une entrée malformée.
Limitation de débit. Plafonnez le nombre de requêtes qu’un client peut effectuer dans une fenêtre donnée. Cela prévient à la fois la surcharge accidentelle et les attaques délibérées par déni de service. Renvoyez le code HTTP 429 (Too Many Requests) avec un en-tête Retry-After lorsque les limites sont dépassées.
Journalisation et surveillance. Journalisez chaque requête API — horodatage, ID client, point de terminaison, méthode, code de statut et latence. Surveillez les journaux pour détecter les anomalies : pics soudains, schémas d’erreurs inhabituels, requêtes provenant de nouvelles plages d’adresses IP. Les incidents de sécurité sont d’abord visibles dans les journaux, pas dans les rapports des utilisateurs.
La passerelle API comme couche de sécurité. Une passerelle API centralise l’authentification, la limitation de débit et la validation des requêtes, réduisant ainsi la surface d’attaque des services backend individuels. C’est le point de contrôle unique où les politiques de sécurité sont appliquées de manière cohérente.
L’autorisation au niveau objet cassée (accéder aux données d’un autre utilisateur en modifiant un ID dans l’URL) se classe systématiquement parmi les vulnérabilités API les plus courantes.
Avant d’écrire du code, définissez ce que l’API fera. Utilisez la spécification OpenAPI (anciennement Swagger) pour décrire chaque point de terminaison, ses paramètres, son format de réponse et ses conditions d’erreur dans un document YAML ou JSON lisible par machine. Une spécification OpenAPI bien rédigée sert de :
Pour la plupart des nouvelles API, REST avec JSON est le choix par défaut — il est largement compris, riche en outils et suffisant pour la plupart des cas d’utilisation. Choisissez GraphQL si les clients ont besoin de requêtes flexibles pilotées par le client et si la sous-récupération est un problème connu. Choisissez gRPC si vous avez besoin d’une communication interne service à service à haut débit et faible latence.
Construisez la logique côté serveur qui exécute le contrat de l’API. Cela implique :
La documentation n’est pas une réflexion après coup. C’est la première chose qu’un développeur qui intègre votre API verra, et elle détermine s’il réussit ou s’il abandonne. Une bonne documentation API comprend :
Des outils comme Swagger UI, Redoc et Postman peuvent générer une documentation interactive à partir d’une spécification OpenAPI, permettant aux développeurs de tester les points de terminaison directement dans le navigateur.
Le test d’API vérifie que l’implémentation correspond au contrat — et qu’elle tient sous charge. Les catégories de tests comprennent :
Acheminez le trafic de production via une passerelle API qui gère la terminaison TLS, l’authentification, la limitation de débit et la surveillance. Déployez l’API dans un environnement conteneurisé ou sans serveur (serverless) qui peut évoluer horizontalement à mesure que le trafic augmente. Surveillez en continu la latence, les taux d’erreur et le débit — et configurez des alertes en cas d’écart par rapport à la référence.
Le test d’API est la pratique qui consiste à vérifier qu’une API se comporte comme spécifié — renvoyant les bonnes données pour les requêtes valides, les bonnes erreurs pour les invalides et maintenant les performances sous la charge attendue. Il se distingue du test d’interface utilisateur : il n’y a pas de navigateur, pas de rendu de page, pas de mise en page visuelle à valider. Le test envoie une requête HTTP et vérifie la réponse.
Le test d’API couvre :
GET /commissions/123 renvoie-t-il les données de la commission 123 — et uniquement celles de la commission 123 ? POST /commissions avec une entrée valide crée-t-il un nouvel enregistrement et renvoie-t-il un statut 201 ?Les tests API automatisés — exécutés dans les pipelines CI/CD à chaque commit — détectent les régressions avant qu’elles n’atteignent la production. Des outils comme Postman, REST Assured et Supertest rendent pratique la création et la maintenance de suites de tests couvrant chaque point de terminaison.
Approfondissez votre compréhension du marketing d'affiliation grâce à notre glossaire complet des termes essentiels du secteur.
Qu'est-ce qu'une API en termes simples, comment pouvez-vous l'utiliser dans Post Affiliate Pro, et quels avantages cela apporte-t-il à votre entreprise ?

Découvrez ce qu'est une API grâce à des exemples concrets tels que la connexion via les réseaux sociaux ou le traitement des paiements. Comprenez comment les AP...
Découvrez comment fonctionnent les API, leur architecture, leurs types et leurs applications concrètes. Guide complet sur les interfaces de programmation d'appl...
Rejoignez notre communauté de clients satisfaits et offrez un excellent support client avec Post Affiliate Pro.


Consentement aux Cookies
Nous utilisons des cookies pour améliorer votre expérience de navigation et analyser notre trafic. See our politique de confidentialité.